
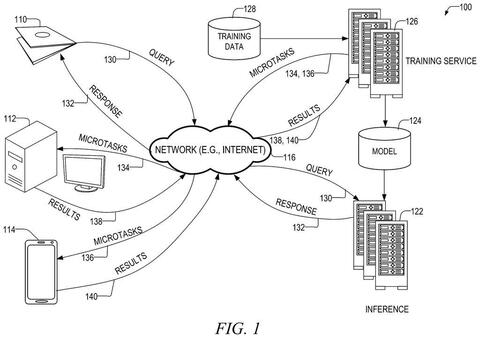
На домашнем ПК освободилась видеокарта. Сервер отправил ей часть расчёта, а через минуту владелец запустил игру. Если к этому моменту результат ещё загружается, серверу придётся решать, ждать ли его и что делать, если параметры модели уже успели обновиться. Для распределённого обучения это гораздо важнее паспортных TFLOPS видеокарты.
10 ноября 2026 года USPTO опубликовало сведения о выдаче Microsoft патента US 12,792,414 B2. В нём описан способ раздавать небольшие задачи обучения устройствам со свободными вычислительными ресурсами. В описании заявки среди таких устройств фигурируют игровые ПК, ноутбуки и смартфоны. Там же приведены варианты добровольного участия и вознаграждения. Публичных замеров скорости обучения на парке домашних ПК в заявке нет. Запись USPTO · Разьор текста заявки US 2026/0349820 A1
Где разрезать вычислительный граф
В первом пункте патента обучение начинается с графа зависимостей. По нему сервер определяет, какие операции можно вынести в отдельные задания и какие данные придётся передать через границу между ними. У каждого разреза три составляющие стоимости: объём обмена между устройствами, дополнительная память для промежуточных результатов и частота обращений к данным, которых нет у исполнителя. Сервер выбирает разрезы с наименьшей взвешенной стоимостью. Пункт 1 патента
В описании есть два варианта разбиения: по компонентам модели и по блокам градиентов. В первом случае у сегмента могут быть входы от соседнего сегмента. Во втором исполнитель считает обновление только для части параметров, но ему всё равно нужны промежуточные данные, от которых это обновление зависит. Например, градиент по весам линейного слоя вычисляется из входных активаций и градиента по выходу слоя. Меньший объём результата сам по себе ничего не говорит о том, сколько данных нужно доставить на ПК перед вычислением. Раздел Microtask Creation
Посчитаем один обмен. Пусть два соседних блока трансформера находятся на разных машинах. Микробатч содержит две последовательности по 2048 токенов, размер скрытого представления равен 4096, формат BF16 занимает два байта на элемент. Тензор на границе блоков весит ровно 32 МиБ: 2 × 2048 × 4096 × 2 байт. При исходящей скорости 20 Мбит/с его передача займёт около 13,4 секунды. Это нижняя оценка для одной отправки, без протокольных накладных расходов. Если градиент по активациям идёт обратно в том же формате и с теми же размерами, через эту границу пройдёт ещё 32 МиБ.
Такой разрез экономит видеопамять на каждом узле, но добавляет обмен на прямом и обратном проходах. Можно держать соседние блоки вместе, заранее размещать входные данные или выполнять больше вычислений между отправками. У каждого варианта своя цена: больше VRAM, необходимость прогревать кэш либо более длинное задание, которое домашний ПК успеет выполнить с меньшей вероятностью.
Сколько работы дать машине, которая может уйти в сон
В заявке планировщик оценивает загрузку GPU, использование памяти, температуру и энергопотребление. История этих показателей помогает прогнозировать окно доступности. Устройству, которое регулярно освобождается на несколько часов, можно выдать более крупную задачу. Устройству с короткими и непредсказуемыми окнами достанется меньшая. Для уже запущенного расчёта описаны пауза или отмена при превышении заданных порогов. Разделы Microtask Adjustments и описание мониторинга
Размер задания ограничивают с двух сторон. Если расчёт длится пять секунд, а подготовка и передача данных занимают пятнадцать, исполнитель три четверти времени тратит вне GPU-вычислений. Если укрупнить задание до нескольких минут, повышается риск потерять результат при отключении ПК. При повторной выдаче серверу нужно учесть и поздний ответ первого исполнителя: обе копии одного задания могут прийти уже после того, как работа продолжилась. Принимать их как два независимых обновления означало бы дважды учитывать один и тот же расчёт.
Как принять запоздавший градиент
В синхронном PyTorch DDP процессы начинают с одинаковых параметров и усредняют градиенты на каждой итерации. Обмен можно начать ещё во время обратного прохода, но к шагу оптимизатора нужные редукции должны завершиться. В схеме Microsoft сервер может принимать результаты по мере поступления. Цена такой свободы видна на одном примере: домашний ПК считал градиент для версии весов №100, а на сервере уже версия №120. Уменьшение веса градиента ограничит его влияние, но направление останется вычисленным для версии №100. Документация PyTorch DDP · Описание агрегации в заявке
Первый пункт патента допускает взвешивать результат по проверке, давности и надёжности исполнителя. В описании есть пример штрафа за возраст по времени. Для оптимизатора имеет значение и то, сколько обновлений произошло за это время. Десять секунд могут стоить одного шага сервера или сотни. Поэтому при испытаниях такой схемы полезно смотреть на распределение отставания в версиях модели и сравнивать время до заданного значения loss. Число принятых обновлений в секунду покажет загрузку системы, но из него нельзя узнать, приближают ли эти обновления модель к нужному качеству. Пункт 1 патента · Фактор давности в описании заявки
Есть и вопрос корректности. В заявке сервер может раздать одну задачу нескольким исполнителям, сравнить результаты и проверить, попадают ли значения в ожидаемые диапазоны. На разных GPU и при разных режимах вычислений для сравнения тензоров нужен допуск. Повторная выдача расходует вычисления: если обе копии задачи выполняются за секунду, из двух GPU-секунд получается одна GPU-секунда уникальной работы ещё до учёта обрывов и просроченных ответов. Описание проверки результатов
С чем сравнивать эту схему
У Google DeepMind есть измерения для другой организации распределённого обучения. В исходном эксперименте DiLoCo восемь исполнителей делали серии локальных шагов и обменивались обновлениями реже. На датасете C4 авторы сообщили о качестве на уровне синхронной оптимизации при сокращении объёма обмена в 500 раз. Это результат для конкретной конфигурации. В более поздней работе Decoupled DiLoCo модель на 12 млрд параметров обучали в четырёх регионах США с каналами между дата-центрами 2–5 Гбит/с. Там каждый вычислительный узел или группа узлов могли долго работать локально. В схеме Microsoft нужно отдельно выяснить, сколько полезной работы успевает сделать машина за одно окно доступности. DiLoCo · Decoupled DiLoCo
Сколько стоит час домашнего GPU
В заявке описаны кредиты, которые можно обменять на деньги, ПО или доступ к модели. Тарифов в документе нет. Для владельца ПК прямые затраты можно прикинуть по дополнительной мощности из розетки. Если компьютер под нагрузкой потребляет на 200 Вт больше, чем в простое, час такой работы добавит 0,2 кВт·ч к счёту. При условной цене 0,30 евро за кВт·ч это 0,06 евро в час. Если ПК в это время обычно спит, базой для расчёта будет потребление в режиме сна. Описание вознаграждения в заявке
Для оператора сравнение с облаком начинается со стоимости достижения одинакового качества на одной модели и одном наборе данных. У домашнего пула в эту стоимость входят выплаты, трафик, перепроверка и серверная часть. Если из десяти оплаченных GPU-часов шесть приходятся на уникальные обновления, которые сервер принял вовремя, один такой час уже стоит в 1,67 раза дороже тарифа, ещё до расходов на передачу данных и агрегацию.
Источник: habr.com