
Привет, Хабр! Мы — Роман Макеев из X5 Tech и Егор Мачнев из Т-Банка — работали над поиском по документам с таблицами, графиками и сложной вёрсткой. Чтобы адаптировать визуальные поисковые модели к нужной предметной области, мы разработали методологию подготовки обучающих данных: берём документы и автоматически генерируем и проверяем запросы к их страницам. Составлять обучающие запросы вручную не нужно. В статье расскажем об этом процессе и сравнении с текстовым поиском. На закрытом корпусе X5-private, который не участвовал в обучении, дообученная ColQwen3-2B получила 0,84 nDCG@5 против 0,77 у лучшей текстовой модели.
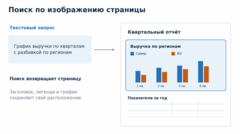 Поиск страницы по текстовому запросу
Поиск по страницам документов
Представим запрос: «график роста выручки по кварталам с разбивкой по регионам». Чтобы найти нужную страницу, системе могут понадобиться заголовок, легенда и сам график. После извлечения текста часть этих связей теряется. У таблицы могут перемешаться строки и столбцы, у схемы останутся подписи без связей между блоками.
Текстовый поиск обычно начинается с парсинга документа или OCR. Затем текст делят на фрагменты и индексируют. BM25 сопоставляет слова, dense-модель кодирует текст в один вектор, а ColBERT сопоставляет векторы отдельных токенов запроса и документа.
Визуальный ретривер получает изображение страницы. Мы рендерим документ постранично и индексируем каждую страницу отдельно. По текстовому запросу система возвращает релевантную страницу.
Для этого взяли две готовые архитектуры: ColPali v1.3 на PaliGemma и SauerkrautLM-ColQwen3-2b на Qwen3-VL. Для дообучения мы собрали RuDoRe и подготовили пары запросов и страниц.
Обе модели используют late interaction. Запрос кодируется в набор векторов токенов, страница тоже получает несколько векторов. Для каждого вектора запроса выбирается максимальное сходство с векторами страницы, затем эти значения складываются:
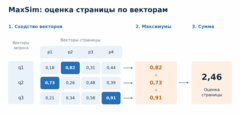 Вычисление MaxSim: сходство векторов, максимумы по строкам и сумма
Такой способ подсчёта сходства называется MaxSim. Он позволяет сопоставлять запрос с отдельными областями страницы. По сравнению с обычным вычислением сходства двух векторов MaxSim требует больше памяти и вычислений, потому что для каждой страницы хранится набор векторов, а каждый вектор запроса сравнивается со всеми векторами страницы.
Сбор и разметка RuDoRe
Мы выбрали 13 тем и составили 656 стартовых поисковых запросов. Через Yandex Search API находили PDF, PPTX и DOCX, скачивали файлы, удаляли дубликаты по содержимому и рендерили страницы. Один прогон собрал около 7 ГБ документов примерно за три часа.
Сбор документов запускали через Temporal: поиск, скачивание и рендер выполнялись отдельными операциями с повторными попытками. Это позволяло повторить отдельную операцию без перезапуска всего сбора.
Дальше Qwen3-VL-32B-Instruct генерировал поисковый запрос по изображению каждой страницы. Затем модель получала judge-промпт с инструкцией проверить, соответствует ли запрос странице и достаточно ли он конкретен. Данные разделяли на уровне документов, чтобы страницы одного файла не попадали одновременно в обучение и тест. При подготовке RuDoRe и X5-private запросы также перефразировали с сохранением смысла.
Для отсева неоднозначных пар применяли фильтр gold_in_top_100: оставляли пару, если исходный предобученный ретривер находил целевую страницу в первой сотне результатов. При таком отборе в датасет могут не попасть корректные запросы, с которыми исходная модель не справилась.
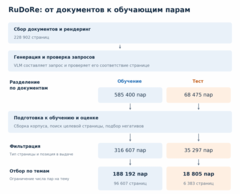 Сбор RuDoRe от скачанных страниц до обучающей и тестовой выборки
Этапы подготовки RuDoRe и размеры обучающей и тестовой выборок.
В обучающую выборку вошли 188 192 пары и 96 607 страниц, а в тестовую — 18 805 пар и 6 383 страницы.
Запросы RuDoRe получены автоматически, поэтому отдельно проверили разметку вручную. Два аннотатора независимо оценили случайную выборку из 150 пар, которые judge допустил в обучающую выборку. В среднем они признали релевантными 89% пар, а их оценки совпали в 94% случаев.
Мы опубликовали датасет RuDoRe и дообученные модели ColPali v1.3 и ColQwen3-2B. Полный обучающий корпус оставили закрытым из-за ограничений на распространение материалов.
Данные, модели и метрики
Для проверки использовали три набора данных:
Набор
Задача оценки
ViDoRe V3
Качество на внешнем многоязычном бенчмарке из семи задач
RuDoRe
Качество на отложенной части нашего русскоязычного датасета
X5-private
Перенос на закрытый корпус русскоязычных бизнес-документов, который не участвовал в обучении
Текстовые модели запускали только на X5-private, где доступен текст документов. На RuDoRe и ViDoRe V3 сравнивали визуальные модели.
В текстовое сравнение вошли BM25 со стеммингом для русского, pplx-embed-v1 в размерах 4B и 0,6B, Giga-Embeddings-instruct, Qwen3-Embedding-4B и jina-colbert-v2. Ещё проверили multilingual-e5-large, его instruct-версию и FRIDA: для них использовали MaxSim по эмбеддингам текстовых фрагментов до 512 токенов. В ColBERT MaxSim сопоставляет векторы отдельных токенов.
ColPali и ColQwen3 сравнивали до и после LoRA-дообучения на RuDoRe. Основной чекпоинт каждого семейства выбирали по nDCG@5 на отложенной валидационной части RuDoRe, затем оценивали на тесте.
Основная метрика, nDCG@5, показывает, насколько высоко релевантные страницы стоят в первых пяти результатах. Значения лежат от 0 до 1; чем больше, тем лучше. Для ViDoRe V3 берём среднее по семи задачам.
Результаты дообучения
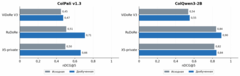 Качество ColPali и ColQwen3 до и после дообучения на трёх наборах
Качество исходных и дообученных моделей на трёх наборах данных, nDCG@5.
На RuDoRe nDCG@5 у ColPali выросла с 0,51 до 0,71, у ColQwen3 с 0,84 до 0,90. На X5-private прирост составил +0,17 у ColPali и +0,02 у ColQwen3. При этом дообученная ColPali уступила исходной ColQwen3 на всех трёх наборах: дообучение не компенсировало разницу между базовыми моделями.
На внешнем ViDoRe V3 средняя nDCG@5 также выросла. У ColQwen3 качество выросло на пяти задачах из семи. На Computer Science nDCG@5 снизилась на 0,46 процентного пункта, а на Physics — на 0,44 процентного пункта. У ColPali качество выросло на всех семи задачах. Если ориентироваться только на среднюю метрику, это ухудшение останется незаметным. Для поиска по информатике или физике важен результат на соответствующей теме.
Сравнение с текстовым поиском на X5-private
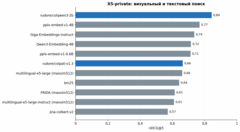 Ранжирование текстовых и визуальных моделей на X5-private
Синим выделены дообученные визуальные модели.
Дообученная ColQwen3-2B получила 0,84 nDCG@5. Лучший текстовый результат у pplx-embed-v1-4B: 0,77. Прирост составляет 9,8% относительно результата pplx. По nDCG@10, Recall@5 и MRR@10 ColQwen3 тоже впереди.
При этом дообученная ColPali с результатом 0,66 уступает нескольким текстовым моделям. Текстовые multi-vector-конфигурации также уступили лучшим одновекторным моделям. Сам по себе переход к изображениям или нескольким векторам на документ не обеспечил преимущество: на этом корпусе замена pplx на ColQwen3 улучшила поиск, а замена на ColPali ухудшила бы его.
При разборе отдельных запросов визуальная модель лучше находила страницы с таблицами, графиками, схемами и сложной вёрсткой, где для ответа важно расположение элементов. На чисто текстовых документах визуальная модель может справляться хуже текстовой. В наших примерах её преимущество почти исчезало, а на некоторых запросах она уступала сильной текстовой модели. Мелкий и неразборчивый шрифт на изображении страницы также может ухудшать качество поиска. Отдельную трудность составляли почти одинаковые страницы: шаблонные слайды или продолжения одной таблицы. Модель могла вернуть соседнюю страницу из того же документа, пропустив небольшое различие, важное для запроса. Поэтому визуальный поиск особенно полезен для документов с графикой и сложной структурой. На чисто текстовых документах выигрыша в качестве может вообще не быть, а расход памяти будет гораздо выше, чем у текстового поиска с одним вектором на документ.
Влияние перефразирования запросов
Исходный запрос генерировала VLM по изображению страницы. При этом она могла заимствовать слова из заголовков, подписей и самого текста. Такой запрос легче сопоставить со страницей по совпадению слов, особенно с помощью BM25.
Мы добавили перефразирование: модель переписывала запрос, сохраняя его смысл. Например, запрос «выручка по регионам за 2025 год» можно переформулировать как «какую выручку получила компания в каждом регионе в 2025 году».
В основные наборы вошли запросы после этого шага. Для сравнения мы сохранили их исходные версии, обозначенные NR (non-rephrased). Корпус страниц, целевые страницы и модели поиска в этом эксперименте одинаковые; меняется только текст запроса.
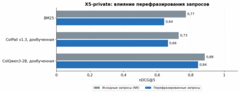 Качество на исходных и перефразированных запросах X5-private
У BM25 nDCG@5 снизилась с 0,77 до 0,64, то есть на 16,7%. У дообученной ColPali снижение составило 8,8% (с 0,73 до 0,66), у дообученной ColQwen3 — 4,5% (с 0,88 до 0,84). Обе визуальные модели оказались менее чувствительны к перефразированию, чем BM25. Этот тест показывает, насколько поиск зависит от конкретных слов в запросе: страница остаётся той же, но другой формулировки достаточно, чтобы качество снизилось. Поэтому в тестовый набор полезно включать несколько формулировок запроса к одной странице: оценка только на запросах, повторяющих её слова, может быть завышена.
При дообучении ColQwen3 замена исходных запросов перефразированными также повысила среднюю nDCG@5 на ViDoRe V3 с 0,53 до 0,55.
Размер модели и дообучение
На X5-private, который не участвовал в обучении, и на внешнем ViDoRe V3 исходные ColQwen3 показали одинаковый порядок по качеству: 8B выше 4B, а 4B выше 2B. В этой линейке увеличение размера модели улучшило качество на обоих наборах. Наш закрытый корпус воспроизводит порядок моделей, наблюдаемый на публичном бенчмарке.
На X5-private дообученная модель 2B приблизилась к исходной модели 4B: обе получили около 0,84 nDCG@5. Исходная модель 8B осталась впереди с результатом 0,87. Для достижения качества исходной модели 4B на этом корпусе оказалось достаточно дообучить модель 2B. Это даёт альтернативу увеличению модели, если есть данные для адаптации. При близком качестве дообученной модели 2B и исходной модели 4B выбор между ними зависит от задержки поиска и расхода памяти.
Скорость и память
Скорость измеряли на X5-private: 668 объектов корпуса и 1595 запросов. Использовали CUDA 12.8, Qdrant и дообученную ColQwen3-2B.
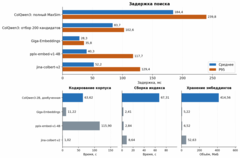 Задержка поиска, время подготовки корпуса и объём эмбеддингов
Сверху: средняя задержка и P95. Снизу: кодирование 668 объектов, сборка индекса и объём эмбеддингов; ColQwen3 выделена синим.
Полный поиск занял в среднем 184,4 мс на запрос, P95 достиг 239,8 мс. В двухэтапной конфигурации сначала отбирали 200 кандидатов, затем пересчитывали их оценки через MaxSim. Задержка снизилась в среднем до 83,7 мс, а P95 — до 102,6 мс.
Если релевантная страница не попала в первые 200 кандидатов, MaxSim уже не сможет вернуть её в выдачу. Уменьшение числа кандидатов ускоряет поиск, но может снизить его качество. При выборе числа кандидатов нужно измерять и задержку, и качество итоговой выдачи.
Кодирование корпуса у ColQwen3 заняло меньше времени, чем у pplx-embed-v1-4B, но сборка индекса оказалась самой долгой среди четырёх моделей. Более быстрое получение эмбеддингов здесь не означало, что поиск по новому корпусу будет готов раньше.
Оценка объёма визуальных эмбеддингов составила 414,56 MiB против 6,52 MiB у pplx-embed-v1-4B и 5,22 MiB у Giga-Embeddings. Это примерно в 64 и 79 раз больше соответственно. При таком же числе векторов на страницу линейная оценка для 100 тысяч страниц составит около 61 GiB только под визуальные эмбеддинги. Дополнительная память потребуется для индекса базы и весов модели.
Состав данных и настройки обучения
Мы сравнили дообучение ColQwen3 с текстовыми страницами и без них, сохранив одинаковое число шагов обучения в обоих запусках. При включении текстовых страниц nDCG@5 на X5-private выросла с 0,84 до 0,86, а на ViDoRe V3 снизилась на 0,63 процентного пункта. Для поиска по X5-private текстовые страницы оказались полезны при обучении визуальной модели, но их сохранение ухудшило результат на внешнем бенчмарке.
Для финальной ColQwen3 выбрали парную логистическую функцию потерь. В батче из 16 пар у каждого запроса есть целевая страница. Страницы остальных пар используем как негативные примеры и выбираем среди них ту, которой модель дала самую высокую оценку. При обучении модель должна поднять оценку целевой страницы относительно этого конкурента:
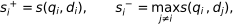
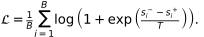
Здесь

обозначает MaxSim, делённый на число токенов запроса,

обозначает размер батча, а

задаёт масштаб разницы оценок. Если чужая страница получает оценку выше целевой, разница

положительна и штраф растёт. Чем увереннее модель ставит целевую страницу выше конкурента, тем меньше штраф. Значения усредняются по запросам батча. При батче из 16 пар такое обучение дало на X5-private качество не ниже, чем обучение с отдельно подобранными негативами.
На качество заметно влияли выбор базовой модели, состав обучающих данных и формулировки запросов. Изменение ранга LoRA, скорости обучения и температуры функции потерь в наших экспериментах влияло слабо. Подбор негативов по теме или позиции в выдаче не давал устойчивого преимущества перед случайным выбором.
Выводы
Мы разработали методологию дообучения визуального поиска на документах нужной предметной области. Запросы для обучения генерирует и проверяет VLM, а люди оценивают качество выборки. Дообучение на RuDoRe улучшило обе модели, в том числе на X5-private, который не участвовал в обучении. Мы опубликовали датасет и дообученные ColPali и ColQwen3.
На X5-private ColQwen3 обошла все текстовые модели из нашего сравнения. Для документов с таблицами и графиками у визуального поиска есть ещё одно преимущество: можно индексировать изображения страниц, сохраняя расположение элементов без восстановления структуры из извлечённого текста. Визуальное ранжирование можно добавить вторым этапом к существующему поиску. В нашем замере предварительный отбор 200 страниц сократил среднюю задержку более чем вдвое.
Главная трудность при увеличении корпуса — объём эмбеддингов. Дальше планируем проверить их сжатие, уменьшение числа векторов на страницу, новые архитектуры и дообучение моделей меньшего размера. Будем сравнивать качество поиска и расход памяти.
Источник: habr.com