
Всем добрый день! Меня зовут Александр. Сейчас я выступаю как приглашенный эксперт, но вообще я редактор, который работает с техническими текстами крупных ИТ‑компаний. Я вижу, как государственные и частные организации встраивают ИИ в работу с данными, и замечаю, что с ним сейчас активно экспериментируют. Часть инициатив исходит от руководства компаний, часть — от сотрудников. Люди пользуются нейросетями сами и видят, что это удобно. Но то, что устраивает обычного пользователя, для организации может оказаться неуместно и даже опасно. Как минимум потому, что почти каждый бизнес работает с персональными данными или коммерческой тайной. А ведь тайна может быть и медицинской, и государственной.
Поговорим о том, какие данные компания может отдавать в нейросети, о частых рисках и реальных ситуациях, которые происходили в мире. А еще — о том, как организовать работу с ИИ так, чтобы максимально снизить риск утечек.
Как можно распределить данные по уровню риска
Когда говорят о рисках для данных, в первую очередь обычно подразумевают утечку. Думаю, тут со мной многие согласятся: размышлять нужно не о том, случится ли утечка, а о том, что будет, если она произойдет. Поэтому я бы определял «рискованность» данных по двум критериям:
-
Что будет, если данные утекут — от банального «ничего» до масштабных юридических процессов с огромными штрафами.
-
Можно ли откатить последствия — условно, поменять на лету планы развития компании сложнее, чем заменить слитый в открытый доступ API‑ключ. А заставить конкурента забыть, что он видел вашу коммерческую тайну, и вовсе невозможно.
Сами данные по этим двум осям я бы распределил так.
Околонулевой риск: открытые данные компании
Если коротко, это то, что уже и так есть в открытом доступе. Например, условный текст с лендинга, который вы уже запустили. Сюда же можно отнести пресс‑релизы, ответы на общие вопросы или публичные документы вроде политики конфиденциальности с вашего официального сайта.
С точки зрения последствий тут всё спокойно. Даже если данные утекут, никакого эффекта для компании не будет, ведь они и так доступны любому человеку в интернете. Это и утечкой‑то нельзя назвать. Откатывать тоже ничего не придется — в этом просто нет смысла.
Низкий и средний риск: внутренние данные без тайн
К этой категории относятся документы, которые, вообще‑то, не предназначены к публикации, но не содержат коммерческой тайны или персональных данных. Например, внутренние регламенты, черновики документов, обезличенные протоколы встреч или описания процессов.
С точки зрения закона утечка такой информации не опасна. Риски тут скорее репутационные, иногда — коммерческие, но не юридические. Будет неприятно, но пережить утечку компания, скорее всего, сможет.
Повышенный риск: данные, полезные конкурентам
Риски растут в случае с данными вроде исходного кода, новостей о неанонсированных продуктах и еще не опубликованных отчетов о финансовых показателях. То есть любой информации, которая дает преимущество конкуренту или нарушает договоренности с другими компаниями. Сейчас поясню, что я имею в виду.
-
Представим, что условная компания N пользуется искусственным интеллектом от конкурирующей компании M. Происходит инцидент: сотрудники компании N отправляют в ИИ исходный код и планы на внедрение новой фичи.
-
Не факт, что сотрудники компании M действительно увидят эти данные. Но вероятность всё‑таки есть. А дальше понятно: компания M может воспользоваться информацией, внедрить фичу раньше, и N потеряет конкурентное преимущество.
Конечно, в реальности мало кто позволяет своим сотрудникам пользоваться продуктами прямых конкурентов. Это абстрактный пример, не основанный на реальных событиях. Но он помогает понять суть. А вот теперь расскажу реальную историю.
В марте 2023 года компания Samsung разрешила своим инженерам пользоваться ChatGPT. И за первые же три недели случилось три инцидента. Один сотрудник загрузил туда исходный код, второй — код для выявления дефектного оборудования, третий — расшифровку совещания. Все эти данные в чистом виде утекли на сервера OpenAI и могли стать базой для обучения ее моделей. На тот момент потребительский ChatGPT по умолчанию обучался на диалогах. Сколько вреда это принесло Samsung, неизвестно. Легально отозвать данные компания не смогла.
Сначала Samsung пыталась ограничивать использование нейросетей сотрудниками, а в мае того же года запретила генеративный ИИ на рабочих устройствах и во внутренней сети. До этого сотрудники почти два месяца продолжали пользоваться ChatGPT. Учитывая размеры компании, это дает потенциально огромный масштаб данных для утечки.
В общем, чтобы утечка принесла вред, не обязательно передавать ее конкурентам в чистом виде. Если модель использует данные для своего обучения и раскрывает их в соседних чатах, это тоже вероятная потеря денег.
Обычно информация, о которой мы говорим в этом пункте, относится к коммерческой тайне. Так что теоретически с подрядчика можно спросить за утечку, хотя это не отменяет самого факта. Но сразу уточню: это возможно, только если в компании введен режим коммерческой тайны. Иначе ничего не выйдет. Данные не будут юридически считаться тайной: вред есть, а взыскать за него компенсацию нельзя.
Максимальный риск: персональные данные, медтайна, гостайна
Мы наконец дошли до самой сложной категории информации. Той самой, которую категорически нельзя раскрывать под угрозой санкций со стороны государства. По этому поводу за меня всё может сказать российское законодательство.
Персональные данные. Их обработку регулирует соответствующий закон. ФИО, паспортную информацию и даже фотографии людей нельзя публиковать и передавать третьим лицам без прописанных в законе оснований. Если компания допустит утечку впервые, ее ждет штраф от 3 до 15 млн рублей в зависимости от объема утекших данных. А при повторном нарушении штраф составляет от 1 до 3% от выручки, причем не меньше 20 млн рублей. Думаю, не стоит объяснять, что это очень много.
Медицинская тайна. Диагнозы, результаты анализов, истории болезней и даже сам факт обращения к врачу охраняются статьей 13 закона № 323-ФЗ.
-
Если компания допустит утечку таких данных, ей грозят штрафы. Причем сразу два: за разглашение персональных данных и информации с ограниченным доступом.
-
Должностные лица попадают под увольнение, а при крупных утечках наступает уголовная ответственность.
-
Для клиник, из которых утекла информация, предусмотрена ответственность вплоть до лишения медицинской лицензии.
Банковская тайна. Сюда относятся сведения о счетах, вкладах, операциях и номерах карт. Здесь риск еще и социальный: если банковские реквизиты человека утекут, этим моментально воспользуются мошенники всех сортов. То есть, кроме штрафов за утечку персональных данных, компании грозит целый комплекс последствий:
-
Банк потеряет репутацию и доверие людей, а это напрямую ведет уже к коммерческому риску потери клиентов.
-
Если из‑за утечки клиенты банка понесли ущерб, компанию ждут суды с пострадавшими, которым придется выплатить компенсации.
-
При крупной утечке банк могут принудительно лишить лицензии и фактически прекратить его существование.
-
Если докажут, что утечку допустили намеренно, для должностных лиц наступает уголовная ответственность.
Государственная тайна. Она стоит особняком от всего перечисленного. Это вообще отдельная категория и совершенно иной уровень последствий даже по сравнению с банками. Штрафы тут уходят на второй план по сравнению с юридическими рисками.
-
Если сотрудник с допуском к тайне допустит ее обнародование, для него практически без вариантов наступит уголовная ответственность. А если сделает это специально с целью помочь иностранному государству, могут использовать и статью о госизмене.
-
Более того: по закону наказуемо и нарушение требований по защите данных, по сути — создание условий для разглашения гостайны. Утечки может даже не произойти, но любой сотрудник, который вольно обращается с отправкой секретных данных, рискует уголовным делом. Например, сюда можно отнести хранение информации на иностранных серверах.
-
Для самой компании, которая такое допустила, последствия не лучше. Утечка гостайны, как правило, означает отзыв лицензии ФСБ, потерю госконтрактов и санкции для руководства, а порой и принудительную ликвидацию.
Как ИИ приводит к утечкам: разбираем на примерах
Одну возможную ситуацию мы уже затронули: нейросеть может использовать данные для своего обучения. Обычно эта опция по умолчанию включена в пользовательских версиях популярных ИИ‑сервисов. В корпоративных версиях ее, конечно, отключают. Но сотрудники нередко решают рабочие задачи с личных аккаунтов и, естественно, не проверяют, включена ли эта настройка. Так что риск сохраняется.
Тут стоит упомянуть еще одну историю по теме обучения ИИ на чужих работах. Примечательно, что речь идет даже не о конфиденциальных данных, а о тех, которые компания уже опубликовала.
В конце 2023 года американское издание The New York Times подало в суд на OpenAI за использование текстов статей для обучения моделей. СМИ утверждало, что это нарушает авторские права и потенциально несет риски для журналистики в целом. В процессе выяснилось много интересных моментов вроде того, что современные модели умеют обходить пейволлы и просматривать платные статьи без подписки.
Но сейчас важнее другое.
-
После долгих разбирательств суд обязал OpenAI хранить все логи ChatGPT как потенциальные доказательства по делу о нарушении авторских прав. Причем даже те чаты, которые пользователи удалили на своей стороне. В октябре требования сняли, но уже накопленные логи пошли в дело.
-
Дальше — больше: суд обязал OpenAI передать The New York Times выборку из 20 миллионов обезличенных диалогов. OpenAI пыталась это оспорить, но в январе суд подтвердил: выборку нужно передать.
Выходит примерно так: обучением ИИ возмутилась одна компания, а пострадали другие. Неизвестно, сколько из этих 20 миллионов диалогов содержали чувствительные для кого‑то данные. Хорошо, что их хотя бы обезличили.
На обучении риски не заканчиваются — возможны ошибки со стороны самого вендора. Это ситуации, когда из‑за бага или недосмотра данные чатов оказываются в открытом доступе. Их могут видеть другие пользователи, иногда информация даже индексируется в поисковых системах. Таких инцидентов уже произошло немало, причем в разные годы:
-
В марте 2023 года в ChatGPT произошел сбой, из‑за которого пользователи могли видеть заголовки чужих диалогов. И не только их: в частичном доступе оказались персональные и платежные данные других подписчиков, включая имена, фамилии и последние 4 цифры банковских карт. Ситуация получила такую огласку, что итальянский регулятор Garante (аналог нашего Роскомнадзора) на месяц запретил использование ChatGPT по всей стране. Когда OpenAI выполнила требования регулятора, доступ восстановили. Кроме того, Garante выписал компании штраф в 15 млн евро, но в 2026 году его отменили через суд.
-
В июле 2025 года пользователи обнаружили, что тысячи личных диалогов с ChatGPT начали напрямую индексироваться поисковиками. Чьи‑то резюме, планы и консультации по личным вопросам отобразились в обычной поисковой выдаче Google, Bing и DuckDuckGo. Незадолго до этого компания внедрила новую опцию для функции «Поделиться ссылкой», которая фактически делала чаты открытыми для поисковых систем. Пользователи кликали по ней не глядя и не подозревали, что отдают свои личные данные в открытый интернет. После скандала OpenAI моментально удалила эту функцию, но уже утекшие данные никуда не исчезли.
-
В августе 2025 года ситуация с поисковиками один в один повторилась в Grok, а в 2026 году — в DeepSeek. Пользователи точно так же начали находить чужие личные чаты в выдаче Google, и виновником опять‑таки оказалась кнопка «Поделиться».
Это только несколько примеров. В реальности ситуаций, когда чья‑то частная информация становилась достоянием общественности из‑за ошибок вендоров ИИ, было еще больше. Причем речь даже не всегда шла о технических сбоях. Например, OpenAI в рамках проекта Project Lily использует команду подрядчиков для выборочного просмотра чатов пользователей. Они оценивают грамотность ответов ИИ и видят диалоги людей, у которых включена настройка обучения модели. В тарифах Free, Plus и Pro она активна по умолчанию.
Подытожить всю эту ситуацию можно так: как только данные улетают на сервера стороннего вендора, для компании, которая их отправила, возникает риск утечки. Потому что от ошибок не застрахован никто.
И наконец, утечки могут произойти из‑за хакерских атак. В частности, из‑за промпт‑инъекций в LLM, которые сейчас, кстати, активно изучают. Тут тоже есть показательный пример.
В 2025 году в Microsoft 365 Copilot нашли уязвимость. На электронную почту пользователя или компании могли прислать письмо со скрытыми инструкциями, замаскированное под обычную рабочую переписку. А дальше всё происходило бы так:
-
Когда пользователь задавал Copilot вопрос по близкой теме, ассистент с доступом к электронной почте находил это письмо среди прочих, читал инструкции и выполнял их.
-
Инструкции предписывали модели собрать из контекста конфиденциальные данные и отправить на сервер атакующего. При этом пользователь мог даже не открывать само письмо.
Когда об уязвимости стало известно, Microsoft закрыла ее на своей стороне. Информации о том, успели ли ее использовать злоумышленники, нет.
Раньше такой возможности не существовало, но развитие ИИ‑агентов внесло коррективы. Модели начали запрашивать доступ к почте, дискам, перепискам компании. Люди пользуются — удобно же. А в итоге увеличивают поверхность для возможной атаки.
Что может сделать компания, чтобы обезопасить данные
Может показаться, что я сейчас агитирую против использования ИИ в работе вообще. Но нет: все мы понимаем, что новый полезный инструмент уже никуда не денется. Дальше рынок будет только расти, а наличие ИИ из конкурентного преимущества превратится в стандарт. Мы видим это уже сейчас: за последний год десятки компаний объявили, что запускают у себя ИИ‑агентов или чат‑ботов.
Нейросети не исчезнут, а значит, компаниям нужно учиться с ними работать, чтобы снизить риски утечек. ИБ‑специалисты опять же говорят об этом не первый год: тут я не придумал ничего нового. Да и стандарты защиты данных уже существуют — расскажу о них подробнее.
ИИ в закрытом контуре
Тут всё логично: модель не передаст данные на чужие сервера, если сама не будет выходить за пределы контура. Это практически база информационной безопасности. LLM разворачивают на собственном оборудовании или выделенных облачных серверах — желательно тоже собственных, а не сторонних.
-
В пользу этого варианта играет то, что модели развиваются. Три года назад self‑hosted модель означала заметную потерю качества по сравнению с лидерами. Сейчас разница сглаживается, а для большинства рутинных задач она уже практически незаметна.
-
Минус только один: самостоятельно развернутую модель нужно поддерживать. А это оплата мощностей, отдельная команда для обслуживания инфраструктуры и так далее. Для крупных компаний это не критично, но условный малый бизнес не всегда может себе такое позволить.
Если самостоятельное развертывание недоступно, можно выбрать промежуточный вариант: доступ к сторонней LLM по корпоративному API при условии, что данные не будут храниться на серверах вендора. Это должно быть четко прописано в договоре.
Тут есть оговорка: хотя договор о нулевом хранении данных предлагают и зарубежные провайдеры, на практике такое сотрудничество возможно только с российскими вендорами. Иностранные, во‑первых, официально не работают с Россией. Во‑вторых, тут в дело вступает положение закона о трансграничной передаче персональных данных, а это дополнительный юридический риск.
Минимизация и обезличивание данных
Люди по своей природе ленивы. Когда они хотят, чтобы модель что‑то им посчитала, они обычно грузят в нее отчет или другой документ целиком. То есть со всеми персональными данными, NDA‑информацией, корпоративной тайной и прочими сведениями, которыми не стоит делиться. Конечно, так делать не нужно.
Перед отправкой в модель данные следует минимизировать — грубо говоря, обрезать, чтобы LLM получила только нужную ей для работы информацию. Не документ целиком, а несколько страниц без полного контекста. Это еще один стандарт безопасной работы, который, кстати, работает даже там, где не справляются все остальные.
Сюда же можно отнести обезличивание информации. Принцип похож на минимизацию: убрать из документа все чувствительные данные.
В моей практике был такой подход: перед тем как отправить транскрипт встречи в модель, специалисты его обезличивали. То есть убирали имена спикеров, упоминания реальных проектов и озвученные финансовые показатели. Только после этого транскрипт передавали в LLM.
Тут можно привести аналогию с реальным миром. Если из квартиры человека вынесут папку со всем набором документов — это проблема. Если вынесут один СНИЛС, всё уже не так страшно. Тоже неприятно, но несравнимо с потерей паспорта, СНИЛС и страхового полиса одновременно.
Обезличивание и минимизацию компания обычно проводит на своей стороне. Но есть редкие сервисы, которые сами предлагают такие модули, а клиент может настроить их по своим политикам безопасности. Из систем учета проектов такое есть у Shtab, но я думаю, со временем идею подхватят и другие сервисы.
Минусы тут тоже есть. То же обезличивание лучше работает для структурированных данных, чем для неструктурированных вроде текста и кода. Структуру кода не вычистишь, а она сама по себе может относиться к коммерческой тайне. К тому же при уменьшении доступного контекста модель может хуже понять задачу. Но это частично компенсируется проверками со стороны человека, о которых я расскажу дальше.
Факт‑чек со стороны человека
Искусственному интеллекту нельзя бездумно верить. Все мы знаем, что нейросети галлюцинируют. Поэтому ручной контроль нужен всегда — как минимум чтобы не возникало вот таких ситуаций.
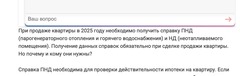 На скрине — отрывок из статьи с сайта муниципального органа. Информация заведомо неверная, и я сомневаюсь, что живой человек смог бы перепутать справку из ПНД с договором о водоснабжении. А вот не очень умная LLM — вполне
Еще один показательный пример — ситуация с авиакомпанией Air Canada в 2024 году. Чат‑бот придумал на сайте компании правило: если у покупателя умер родственник, компания по заявке даст ему скидку на уже купленный билет. В реальности такого правила не было. А когда пассажир действительно подал такую заявку и компания отказалась платить, дело дошло до суда. Сумма была относительно небольшой, но прецедент неприятный.
В моей практике такие ситуации тоже случались. Бывало, что модель генерировала черновики текстов для публикации с выдуманной статистикой и упоминаниями конкурентов. При этом правила самой компании запрещали писать о конкурентах в статьях. Если бы ошибку не нашли на редактуре, выдуманную информацию опубликовали бы от лица компании — а это репутационные риски и нарушение редполитики.
В общем, проверять информацию важно и с точки зрения утечек, и на предмет галлюцинаций. Лучше всего — минимум дважды:
-
До отправки в модель — чтобы убедиться, точно ли в документе не осталось каких‑либо чувствительных данных. Ни один коммит или письмо клиенту не должно уходить наружу без предварительной оценки человеком.
-
После получения результата — чтобы не сломать всё из‑за случайной галлюцинации. Я бы сформулировал это правило так: не доверять выходу сильнее, чем входу. Сначала результат проверяет человек, и только потом его начинают использовать.
Здесь, кстати, есть позитивные примеры. Один из них — Госуслуги, точнее, их робот Макс, который отвечает на запросы пользователей. Сами ответы выдает нейросеть, но ищет их по схеме RAG: формирует ответ по найденным материалам портала. Есть и готовые ответы, продуманные людьми. Такая схема заметно снижает риск выдумок: робот вряд ли направит человека в ведомство, которого не существует, или переврет законодательство.
Прокси с проверкой промптов
Безопасники часто говорят, что человеческий фактор важнее всего. Можно десять раз сказать человеку, чтобы он убрал чувствительные данные из промпта, а он всё равно туда их вставит. Поэтому золотое правило — людей должна страховать автоматика. Так, кстати, делают даже на электростанциях.
Речь о такой схеме:
-
Компания внедряет между моделью и сотрудниками корпоративный шлюз, который блокирует или маскирует информацию, подпадающую под фильтры. Например, номера карт, паспортные данные, ключи API.
-
Если сотрудник попытается отправить чувствительную информацию во внешнюю нейросеть, прокси это заметит, обезличит данные на лету или вообще заблокирует запрос.
По похожему принципу работают PII‑фильтры для автоматического обезличивания. Я уверен, что для минимизации в ближайшее время тоже появятся решения.
Тут есть оговорка: прокси может ловить данные, но отследить всё нереально. Вопросы у людей могут быть самыми разными, формулировки — тоже. Типизировать и задать правило для каждого возможного промпта физически невозможно. Но как дополнительный слой защиты подход работает.
Контроль за соблюдением ИБ‑политики
К сожалению, фраза «мы прописали политику безопасности» не всегда означает, что за ее соблюдением кто‑то будет следить. А ведь политика не должна быть просто документом, чьи положения никто не выполняет. Такой подход просто создаст красивую картинку для аудитора и никак не поможет защите данных.
Чтобы политика безопасности реально работала на практике, выполнение ее требований следует контролировать. А для этого как раз нужны прокси, периодические проверки логов и в принципе отслеживание действий пользователей. Главное — не превращать контроль в вахтерство, но это уже немного другая история.
И еще кое‑что: запреты не работают. Вы можете сколько угодно запрещать сотрудникам пользоваться ИИ с рабочих устройств, ограничивать доступ и отслеживать активность. Ничего из этого не помешает условному менеджеру открыть ChatGPT с телефона и скопировать туда половину данных о проекте. А потом ИБ‑служба будет днями искать, откуда взялась утечка.
Правильнее и разумнее дать людям настроенный инструмент с выставленными правами доступа. Именно так поступают компании, о которых мы не слышим в новостях — просто потому, что у них не случалось серьезных инцидентов. О хорошем, как известно, говорят меньше, чем о плохом.
В общем, если коротко — от ИИ никуда не деться. Сотрудники всё равно будут им пользоваться. Так что и компаниям нужно учиться с ним работать, а не ставить жесткие барьеры.
Выбор инструмента с ИИ: как обеспечить безопасность
Сначала классифицируйте данные, потом выбирайте инструмент. То есть определитесь, какую информацию вы не против отдавать нейросети, а какая слишком чувствительна, чтобы ею делиться. Пока вы не решите, к какому уровню риска относятся те или иные данные, любой выбор инструмента — это гадание на кофейной гуще.
Проверьте, какие именно модели использует сервис. По возможности, конечно, стоит выбирать развертывание LLM в локальном контуре. Но будем честны: не всем подходит on‑premise. Если решились на облако, посмотрите, что за модели у инструмента внутри. Лучше всего — чтобы это были собственные наработки компании или российские нейросети. Потому что бывает и иначе.
Встречаются отечественные сервисы, которые по факту работают на базе моделей OpenAI или Anthropic. То есть данные будут уезжать к стороннему провайдеру на его условиях. Информацию об этом обычно пишут в договоре об обработке данных, а не в маркетинговых материалах — еще один повод внимательнее читать документы перед подписанием.
Тут есть свежий пример. Недавно Anthropic заявила, что китайский ИИ‑сервис Moonshot (Kimi) внутри обращался к API Claude. Так же, по ее словам, действовали DeepSeek и сервисы Xiaomi. Люди пользовались инструментом и думали, что данные остаются внутри китайского контура — а они улетали в США. Минкоммерции КНР отверг обвинения.
 О ситуациях, когда одни нейросети отправляют данные другим или пользуются их наработками, уже немало мемов. Как говорится, «только один в один не списывай»
И да: если вы не видите проблем в том, что вендор пользуется сторонними моделями, лучше всё равно предварительно минимизировать и обезличивать данные. В некоторых сервисах, вроде того же Shtab, поставщика LLM можно выбирать, а модуль для обезличивания предусмотрен из коробки, но пока это, к сожалению, редкость.
Почитайте, что с данными происходит под капотом. Речь не только про отправку в сторонние модели. Например, проверьте срок хранения информации, права на нее, уточните, кто имеет право запрашивать данные из чатов в случае необходимости. И, конечно, не стоит разрешать модели обучаться на реальных данных вашей компании.
Узнайте, как распределяются права доступа. ИИ‑ассистент может наследовать их от пользователя, который с ним работает, а может не наследовать. Во втором случае есть риск, что сотрудники получат доступ к задачам, которые не должны видеть.
Исходите из того, что риски инцидентов есть всегда. Это справедливо для любой компании и любого вендора. Ошибаются даже топовые специалисты из Microsoft и OpenAI — в статье достаточно примеров, чтобы это подтвердить.
Вопрос даже не в том, случится ли инцидент. Важнее другое: сможет ли компания пережить последствия. И вот здесь всё как раз зависит от того, насколько тщательно она подходит к минимизации и обезличиванию данных перед отправкой в ИИ.
Вывод: какими данными можно делиться с ИИ
Если честно, формулировка «доверие к ИИ» кажется мне странной. Это ведь не оракул, а предиктивная модель, которая на основе своего обучения предсказывает наиболее вероятное продолжение текста. Я бы ставил вопрос иначе. Примерно так:
«Какие данные мы готовы увидеть на экранах у своих конкурентов или в материалах судебного дела?»
Всё, что не попадает в список таких данных, сторонним моделям отдавать нельзя. Даже самым умным и продвинутым. Отправлять их в LLM можно после обезличивания или минимизации до того уровня, на котором делиться информацией становится безопасно.
И кстати, обычных людей всё перечисленное тоже касается. Приведу аналогию с фильмом «Нация убийц»: там хакер взломал историю поиска половины жителей города, и в обществе начался ад. А ведь у них даже не было корпоративной тайны — просто личные секреты, которыми они не хотели бы делиться. Можете посмотреть, если не воротит от жести. Или не смотреть, ведь я уже всё проспойлерил.
На этом у меня всё. Будьте внимательны при работе с ИИ и выбирайте надежные инструменты. Ну и, конечно, не забывайте проверять всё человеком.
Источник: habr.com