
Первая версия. Верной оказалась примерно треть ответов.
Опросный лист на КИП (контрольно-измерительные приборы) похож на анкету для поставщика прибора: диапазон, климат, взрывозащита, материалы. Ответы раскиданы по сотням страниц техзадания, и инженер выуживает их руками. В сентябре я решил, что это идеальная работа для LLM.
Сейчас на стенде система совпадает с инженером в 73–86 % строк, где он ответил, на трёх объектах, ответов которых она не видела. Нейросеть в ней осталась, но до этих цифр её довели совсем другие вещи.
Попытка первая: пусть модель отвечает
Схема в лоб: на каждую ячейку двенадцать похожих фрагментов ТЗ, модель пишет ответ и цитату, код проверяет, что цитата настоящая. Итог на пилоте: верно примерно в трети ячеек.
Модель не умела сказать «не знаю» и отвечала хоть чем-нибудь, а иногда возвращала примеры из промта слово в слово, с безупречной уверенностью.
Попытка вторая: модель в стажёры
Я убрал модель из ячеек. Заполнять стали правила и справочник, а модель только выписывала факты в конспект. Там, где правило или справочник срабатывали, верно было 86–92 %, я почти открыл шампанское. А по всем ячейкам двух чужих объектов вышло 58 %.
Ошибались и правила, только изящнее. «Гарантия: 30 лет» на деле была сроком службы агрегата, а нужные 36 месяцев лежали рядом. Цитата настоящая, пункт чужой, и проверка «цитата есть» такое пропускает с лёгким сердцем. Правила, написанные на ошибках объекта, прекрасно работают ровно на этом объекте.
Холодный душ
Потом систему попробовал инженер заказчика. Заполнено 25 строк из 78, и вывод был неприятный: это лёгкая часть, типовые строки везде одинаковые.
Я полез считать, сколько ответов инженера вообще есть в документах. На первых четырёх объектах среди нетиповых строк их не нашлось в 65–83 %. Двадцать таких строк я проверил руками: около половины оказались решениями отдела. Их никто не пишет в ТЗ, они годами переходят из листа в лист.
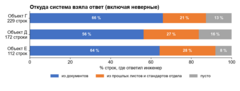
Сейчас, на трёх новых объектах, по всем строкам, где ответил инженер. Без прошлых листов отдела система упиралась бы примерно в две трети.
Давид против Голиафа
Ответы, которые в документах есть, надо оттуда достать. Я устроил соревнование моделей, включая Qwen3.8-27B на сервере. Точнее всех, слово в слово как у инженера, значения выписывает NuExtract3 на 4B, которую учили ровно одному: вытаскивать данные в заданный шаблон. Если засчитывать и «почти» (то же значение, другая запись), обычные 4B её догоняют и даже чуть обходят.
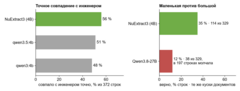
А вот большая модель проиграла маленькой всухую. На одних и тех же кусках она промолчала в 197 строках из 329, и в 63 из них NuExtract3 нашла верный ответ. Там, где 27B всё-таки ответила, она права в 29 % случаев против 35 % у маленькой.
Остальные идеи тоже не взлетели:
Что пробовал
Что вышло
Рассуждение (thinking)
30 % против 35 %, 20 с на запрос вместо 2,6
8 бит вместо 4
58 % и 58 %
Ответ копится по трём окнам
53 % против 58 %
Datalab lift 9B
57 % против 86 % на 14 строках
Решатель Jev на строках «Да/Нет»
37 из 60 против 48 у NuExtract3
Переранжировщик Qwen3-Reranker
нужный кусок в тройке: 85 → 74 %
Важнее модели оказался поиск. Если нужный кусок документа доходил до модели, она отвечала верно в 52–78 % строк, если нет, в 11–25 %.
А если дообучить поиск?
Куски по смыслу ищет эмбеддинг-модель, и её можно доучить языку заказчика. Пары «строка листа → пункт ТЗ, откуда инженер взял ответ» у меня были. Маленькая русская USER2-base училась на них минут пять на ноутбучной видеокарте и на двух чужих объектах стала выбирать верный пункт в 63 % строк вместо 52. В тройку лучших верный пункт попадал в 85 % строк.
С моделями покрупнее вышло хуже. bge-m3 подтянулась на одном объекте и провалилась на другом, Qwen3-Embedding-0.6B просела на обоих. Ошибка была моя: для адаптеров LoRA я взял ходовой шаг обучения 1e-4, а такие модели доучивают в десять раз осторожнее, с шагом 1e-5. С ним учили и саму Qwen3-Embedding. Слишком большой шаг не доучивает модель, а перестраивает её под формулировки одного объекта. FRIDA за эпоху не сдвинулась, пары, которые нагенерировала 4B-модель, ничего не добавили, а дообученный переранжировщик поверх только мешал.
Самое обидное: верных ответов в ячейках не прибавилось ни одного. Поиск поднимал нужный пункт выше, но правило брало первый кусок, из которого вообще что-то извлекалось, та самая «Гарантия: 30 лет». Прибавку дали два простых правила: в куске должно быть значимое слово строки, а у срока должна быть единица.
Готовый решатель NeoHorse-Jev-4B выбирал пункт ещё точнее: 74 %, а если дать ему четыре лучших пункта от нашей модели, 82 %. Только значение от этого лучше не становилось. Когда модель видела все кандидаты, она выписывала верное значение в 60 % строк с числами, а после отбора Jev в 51 %. Ответ часто лежит в двух пунктах сразу, например минимальная и максимальная температура в разных строках таблицы, и отбор одного пункта отрезает половину. Поэтому в систему Jev так и не попал: точнее выбрать пункт мало, если ответ от этого хуже.
Под NuExtract3 потом лучше сработал обычный поиск по словам. Поиск по начальным формам слов поднял попадание нужного куска в тройку на одном объекте с 48 до 68 %. Ответы похожих строк из прошлых листов, добавленные в запрос, на другом объекте подняли его с 4 до 39 %. Дообученная модель осталась в одном вспомогательном канале и ждёт пар с новых объектов.
А если попросить додумать?
Раз в пустых строках ответа в документах нет, может, модель предложит его сама, по нормам и здравому смыслу?
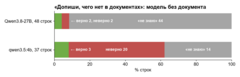
Маленькая уверенно ошибается, большая честно молчит. Решения отдела из воздуха не выводятся.
Сначала научиться честно мерить
Прежде чем улучшать дальше, пришлось научиться мерить. Цифры обманывали меня трижды:
-
в четверти строк инженер не пишет ответ, а ставит флажок у варианта «Да» или «Фланцевое», а сверка читала текст ячейки со всеми вариантами сразу;
-
проверяемый объект подглядывал в собственные ответы через старые стандарты в базе: 71 % вместо честных 61;
-
сверка считала верным «похоже на 90 %», и IP54 спокойно сходил за IP65.
После этого любое правило оставалось, только если поднимало цифру на трёх объектах, ответов которых система не видит:
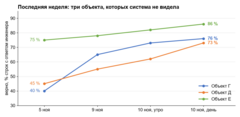
Неделя работы. Сверка по ходу менялась, так что точки сравнимы приблизительно. Ответов этих объектов система не видит, но правила я искал на их ошибках, а для Г и Е таблицы со сканов перепечатали в Excel руками. Так что это стенд, а настоящий экзамен будет на новом объекте.
Что сработало
Пустая строка лучше выдуманной. Сначала то, в чём система уверена: таблицы и правила по документам, стандарты отдела, ответы прошлых листов. Потом модель, и только с опорой на документ. Если ответа нет нигде, строка остаётся пустой и красной.
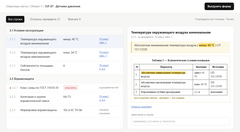
Данные на макете выдуманы.
Каждый ответ с адресом. Рядом со значением стоит ссылка на пункт: «ТЗ изм.2, табл. 1». Щелчок открывает карточку с цитатой и саму страницу документа, где нужное место подсвечено жёлтым. Инженеру не надо верить системе на слово, проверка в один щелчок. Пустые строки собираются в письмо «Вопросы заказчику», а готовая форма выгружается в бланк отдела.
Ответ модели только с опорой. Значение встаёт в строку, только если все его числа и коды есть в одном куске документа, который модель видела. Остальное идёт в варианты с пометкой «в документах этого нет».
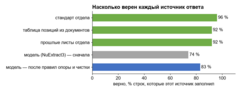
Аналог из прошлых листов, если на двух объектах ответили одинаково. На прежних объектах такие ответы были верны в 71–84 % случаев, а взятые с одного объекта только в 46–62 %. Поэтому ответ с одного объекта сам встаёт только в типовых строках вроде материала или исполнения, а в остальных идёт вариантом: параметры среды одного объекта не должны молча переехать к соседу. И ответ модели аналог не заменяет: где ответили оба, модель права чаще, 76 % против 72.
Вывод по норме только вариантом и с объяснением. Зона по ГОСТ выводится из класса по ПУЭ, группа и температурный класс взрывозащиты из газа этой зоны, климатическое исполнение из места установки. Система такое значение не вписывает, а предлагает с подписью «почему».
Колонки по ролям. В бланках отдела есть колонка «ответственный отдел» с кодами вроде 340, и модель брала их за значения. Теперь колонка узнаётся по шапке или по самим ячейкам и в текст для модели не попадает.
Разные глаза для текста и чертежей. Таблицы на сканах лучше всех читает LightOnOCR-3 4B. А младшая LightOnOCR-3 1B на схеме видит картинку целиком и выдумывает позиции пачками.
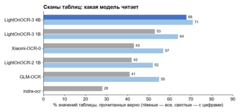
Четыре скана, сверка с их Excel-копиями.
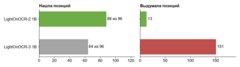
151 позиция, которой на схеме нет. Для схем теперь работает пара моделей, qwen3.5 и GLM-OCR.
Всё без интернета. Сервер заказчика стоит в закрытой сети. Код едет туда архивом с картой файлов и контрольными суммами, модели скачиваются на машине с интернетом и ставятся одной кнопкой. Старый Word (.doc) читается вместе с картинками прямо из файла, без установленного Office.
Последний сюрприз: половина бланка вовсе не вопросы
Меня долго мучило: почему лист инженера заполнен целиком, а наш наполовину? Ответ нашёлся в самом бланке. Больше половины его строк вообще не вопросы, а напечатанный текст: пункты требований, перечень документации, подписи. Правая ячейка у них принадлежит поставщику, он пишет туда «подтверждаем». Инженер её не трогает.
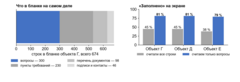
А моя система старательно считала их пустыми вопросами и кое-где даже заполняла: вписывала фамилии в подписи и «12500» к сроку службы. Когда текст бланка перестаёт считаться, «заполнено» вырастает с 45 до 81 %. Верных ответов при этом не прибавляется ни одного. Просто система наконец считает то же, что считает инженер.
Дальше она будет только умнеть
Главное, что я понял за два месяца: система не должна каждый раз начинать с нуля. Поэтому она запоминает.
Ответы инженера остаются в базе. Подтверждённое значение сохраняется вместе с цитатой, а вписанное руками с прибором и автором. На следующем объекте это уже прошлый лист, из которого берутся аналоги. Любой ответ можно отправить в стандарты отдела, и при следующем заполнении он встанет сам там, где документы молчат.
Глоссарий учит систему языку инженеров. В форме пишут «давление начала открытия», в документах «Рн.о.», «давление настройки» или вовсе «set pressure». Такие понятия собраны в общий словарь, сейчас их 143. Его можно править прямо на странице, и при следующем заполнении система узнаёт строку формы в таблицах документов.
Получается простая арифметика. Каждый заполненный объект добавляет прошлых листов. Чем их больше, тем чаще ответ находится на двух объектах сразу и встаёт в строку оранжевым, инженеру остаётся подтвердить. Пустых строк, которые сейчас приходится вписывать руками, с каждым объектом должно становиться меньше.
Источник: habr.com