
Проблема, которая не выглядит как авария
В production далеко не каждая проблема выглядит как инцидент. Основные графики остаются зелеными, алерты не срабатывают, сервис в целом доступен — но на конкретном этапе пользовательского пути растет доля неуспешных операций или увеличивается время ответа. Для отдельного пользователя это уже поломка, хотя для системы в целом — еще нет.
В команде регистрации на Финуслугах мы каждую неделю вручную проходили один и тот же путь: смотрели метрики в Grafana, проверяли логи в OpenSearch, локализовывали проблемную бизнес-операцию, а затем искали связанный участок кода. Только на первичную диагностику уходило от четырех до восьми часов в неделю — еще до того, как инженер мог решать, что исправлять.
Автоматизировать хотелось именно эту часть процесса: не принятие инженерного решения, а сбор фактов и подготовку гипотезы. Так появился ИИ-завод на Multica — ночной контур, в котором AI-агенты анализируют сигналы мониторинга, собирают технический контекст, сопоставляют отклонения с кодом и готовят черновик задачи для инженера.
За время развития системы она помогла найти проблемы, суммарно затрагивавшие около 1600 регистраций.
От сигнала к действию: что изменилось в процессе диагностики
Раньше между отклонением на дашборде и понятной задачей для разработки стояла цепочка ручных действий: тимлид замечал сигнал, подключал инженера, тот собирал логи, находил код и формулировал гипотезу.
Теперь значительную часть этого пути система проходит ночью. Утром инженер получает не сырой поток метрик и логов, а структурированный результат: какая бизнес-операция отклонилась от нормы, насколько сильно, какими данными это подтверждается, где искать связанный код и что могло стать причиной.
Если отклонение подтверждено, Multica формирует черновик Jira-задачи. В него попадают бизнес-операция, фактические значения метрик, нарушение SLA, технический контекст, причина и предложение по исправлению.
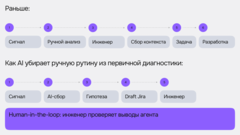
Ключевое слово здесь — «черновик». Система не отправляет задачу в разработку автоматически. Инженер проверяет выводы, оценивает влияние, при необходимости корректирует описание и только после этого переводит задачу в обычный backlog команды.
Как устроен ночной контур
По расписанию — в терминологии Multica это Autopilot — создается задача, которую подхватывает OpenCode. Дальше управление получает lead-agent. Через MCP он читает в Confluence каталог бизнес-операций и правила контроля для каждой из них, а затем разбивает анализ на независимые дочерние задачи.
В базовом сценарии для Prometheus у нас 21 бизнес-операция. Lead-agent делит их между семью дочерними агентами — по три операции на каждого. Они параллельно проверяют свои участки, сравнивают фактические показатели с правилами и возвращают компактный результат.
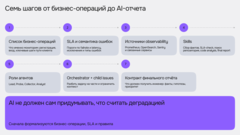
Мы сознательно разделили диагностику на два этапа. На первом модель не должна угадывать причину. Probe- или collector-agent работает в одном контуре наблюдаемости и отвечает на узкий вопрос: есть ли отклонение и насколько оно существенно.
Для Prometheus это показатели успешности операций, ошибок и latency; для OpenSearch — агрегаты по HTTP-кодам, сообщения об ошибках и примеры trace; для Sentry — frontend-ошибки и время загрузки страниц. Результат сравнивается с заранее заданными SLA и baseline, после чего операция получает статус OK, WARNING или BREACH.
Каждый probe или collector-agent возвращает промежуточный отчет — короткую карточку с бизнес-операцией, фактическим значением, SLA, baseline и подтверждающими данными. Только карточки со статусами WARNING и BREACH передаются analyst-agent’у, который открывает связанный репозиторий и формирует гипотезу причины.
Почему нельзя просто отдать модели все логи
На старте очень соблазнительно сформулировать задачу так: «Посмотри все сервисы, метрики, логи и код, найди что-нибудь подозрительное и напиши отчет». На практике такой сценарий быстро упирается в время выполнения, размер контекста и качество ответа. Чем больше неоднородных данных получает модель, тем сложнее понять, на каких фактах основана конкретная гипотеза.
Поэтому observability и правила SLA сначала сужают пространство поиска. Большая задача делится на подзадачи, каждая из которых получает ограниченный набор бизнес-операций и возвращает структурированный артефакт. Для нас подзадача — это одновременно единица параллелизма и граница контекста.
Такой подход дал несколько практических преимуществ:
-
анализ выполняется параллельно;
-
контекст каждого агента остается ограниченным и предсказуемым;
-
детерминированные расчёты не смешиваются с рассуждениями LLM;
-
упавшую или неточную часть можно перезапустить отдельно;
-
качество можно контролировать на уровне конкретной роли и конкретного артефакта.
Три источника данных — три разных вопроса
Систему мы развивали последовательно. Сначала подключили метрики, затем логи, а после — мониторинг фронтенда. Эти источники не дублируют друг друга: каждый отвечает на свой вопрос.
Prometheus: где возникло отклонение
Prometheus помогает быстро определить, на каком участке пользовательского пути что-то изменилось. Агент считает failrate для бизнес-операций, анализирует latency и проверяет соблюдение SLA. Это первый фильтр, который позволяет не анализировать систему целиком.
OpenSearch: что именно произошло
Метрика показывает отклонение, но не всегда объясняет его причину. Кроме того, некоторые участки кода могут быть покрыты метриками недостаточно подробно. Поэтому вторым слоем стали логи.
Если источник проблемы находится не в нашем репозитории, агент может перейти в репозиторий смежной команды — при условии, что у него есть доступ. Связь он определяет по техническим зависимостям, например по вызовам Feign.
Sentry: что происходит на фронтенде
Sentry добавил принципиально другой класс данных: frontend-ошибки и производительность страниц. Страница может почти не генерировать ошибок, но загружаться настолько медленно, что для пользователя она фактически не работает. Backend failrate такую проблему может не показать.
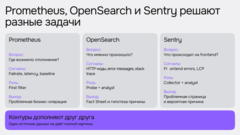
Страницы также классифицируются по SLA. Analyst-agent получает только проблемные, открывает frontend-репозиторий и ищет возможную техническую причину. Так система начала видеть деградации интерфейса, почти незаметные в backend-метриках.
Как расширение видимости меняло результат
Первая версия, которая работала преимущественно с Prometheus и кодом, нашла пласт тихих проблем, затрагивавших около 1000 регистраций. После исправлений результат вышел на плато.
Подключение OpenSearch добавило HTTP-коды, сообщения об ошибках, stack traces и контекст запросов. Это открыло ещё один пласт проблем — примерно 600 регистраций. После исправлений снова наступило плато. Sentry принес уже не просто дополнительные данные, а новый тип сигнала — frontend и performance.
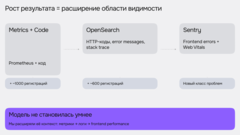
Результат рос не потому, что модель становилась «умнее». Мы расширяли область ее видимости. Метрики дали один слой, логи — второй, мониторинг фронтенда — третий. Для production-диагностики качество входных сигналов и их семантика оказались важнее попытки выбрать самую большую модель.
Почему у failrate нет одной формулы
При автоматизации быстро выяснилось, что ошибки нельзя считать одинаково. В HTTP-логах ответы 500 и 401/403/422 имеют разную семантику. Для критических 4xx/5xx нужен один допустимый уровень, для ожидаемых ошибок — например, истекшей сессии или ошибки валидации — другой. У отдельных бизнес-операций есть собственные исключения.
На фронтенде ситуация еще сложнее: низкая доля ошибок не гарантирует нормального пользовательского опыта, если страница загружается слишком долго. Поэтому AI не заменяет observability-модель. Наоборот, агент становится полезнее по мере того, как команда точнее описывает бизнес-операции, SLA, baseline и семантику сигналов.
Как встроить результат в работу команды
Можно построить агента, который каждое утро приносит двадцать страниц анализа. Если команда не превращает этот отчет в решение, ценность системы близка к нулю. Поэтому диагностический контур должен быть частью обычного инженерного процесса, а не отдельной AI-демонстрацией.
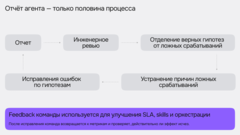
После исправления мы возвращаемся к метрикам и проверяем, исчез ли эффект. Одновременно полезно разбирать не только найденную проблему, но и путь, которым к ней пришёл агент. Так вокруг AI-системы возникает обычный инженерный feedback loop.
Если произошло ложное срабатывание, уточняем SLA, исключения или формулу. Если ему не хватило данных — дорабатываем observability или skill сбора контекста. Если он выбрал не тот репозиторий — улучшаем skill исследования зависимостей. Если контекст снова разросся — меняем декомпозицию подзадач. Если отчёт слишком шумный — ужесточаем контракт финального отчета.
Что мониторить в самой AI-системе
Регулярно запущенный диагностический контур тоже становится production-системой. Поэтому следить нужно не только за исходным сервисом, но и за качеством работы агентов. Я бы включил в минимальный набор:
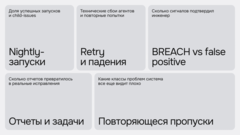
Эти метрики показывают не просто активность агентов, а стабильность и практическую пользу всего процесса.
Как собрать похожий контур
Первый шаг — не создание AI-агента. Сначала нужно формализовать, что именно система должна считать проблемой и с чем сравнивать production-сигналы. Без этого LLM будет воспроизводить неопределённость, которая уже есть в мониторинге.
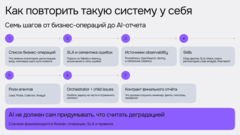
Финальный отчёт лучше зафиксировать как контракт: операция, severity, факты, влияние, связанный код, гипотеза, уровень уверенности и следующее действие.
Что дальше
Сейчас система анализирует backend-метрики, HTTP-логи, frontend-ошибки и связанный код. Следующий логичный шаг — сокращать расстояние между подтверждённой гипотезой и исправлением: готовить более детальные задачи, предлагать типовые варианты исправлений и со временем формировать MR вместо черновика Jira-задачи.
Но с ростом автономности растёт и цена ошибки. Чем ближе агент подходит к реальному изменению production, тем важнее проверка человеком, контроль доступа, воспроизводимость анализа и возможность увидеть, на каких фактах основано решение.
В этой истории наиболее полезным оказался не автономный «AI-инженер», которому отдали весь production. Сработала система с узкими ролями, формализованными границами и понятной точкой человеческого контроля. Именно такое сочетание автономного ночного анализа и управляемого feedback loop сегодня выглядит для нас самым практичным способом применять AI в production-диагностике.
Источник: habr.com