
Автор: Сергей Никоненко, Руководитель агентства разработки мобильных и веб-приложений. Пишу на Хабре лично, а данные беру из внутренних отчетов: сметы продаж, списания времени в Jira, коммиты GitLab.
Меня в разговорах про ИИ больше всего интересует простой вопрос: сколько теперь стоит сделать приложение? Проценты сгенерированного кода сами по себе мне мало помогают. Поэтому я взял свои сметы, списания времени в Jira и коммиты GitLab и попробовал разобраться в часах и деньгах.
Коротко: на авторизацию в сметах стали закладывать заметно меньше часов. Цена часа тоже снизилась, но скромнее. А два веб-проекта с агентами потребовали меньше часов разработки, чем предполагали старые бюджеты. Вот цифры:
Эти х2,5 и х3 показывают разницу со старым бюджетом. Одну и ту же работу с агентами и без них здесь не измеряли. И х3 у второго проекта я округлил вниз с расчетных х3,8.
Что сравнивал
Что увидел
Авторизация в сметах 2025 → 2026
Медиана 124 → 56 ч, n = 12 / 19
Ставка разработки за тот же период
Медиана 3 900 → 3 600 ₽/ч
ИИ-first реализация против старых бюджетов
х2,5 и консервативные х3
За таблицы я взялся из-за разницы между обещанием автоматизировать написание кода и ожиданием, что от этого подешевеет вся разработка: первое еще не объясняет, насколько изменится второе. Дарио Амодей, CEO Anthropic, 10.03.2025 сказал в блоге Redwood Research:
I think we’ll be there in three to six months—where AI is writing 90 percent of the code.
Позже Сатья Наделла, CEO Microsoft, 29.04.2025 описал положение в Microsoft в эфире CNBC:
Maybe 20%, 30% of the code that is inside of our repos today and some of our projects are probably all written by software.
Наделла оценивает код в собственных репозиториях. Ну и как из этих процентов посчитать цену приложения? Заказчику нужен работающий продукт, а мне надо понимать, сколько времени уйдет на его разработку. Доля ИИ-кода сама по себе на этот вопрос не отвечает.
Поэтому я решил проверить три вещи: как меняются оценки типовых фич, сколько часов списывает команда и видно ли в истории проекта участие агентов. Тут и выясняется, сколько всего можно потерять, если просто поделить бюджет на факт и назвать результат ускорением.
Для этого свел три источника: сметы, Jira и GitLab. У каждого своя задача, и дальше будет видно, почему одного из них мало.
В архиве 4 910 смет, но для сравнения нужны документы с одинаковой структурой. Оценки авторизации удалось сопоставить в 12 сметах за 2025 год и в 19 за 2026-й. Цену часа проверил отдельно: по семи сметам каждого года. Ее брал из таблицы состава команды, где напротив каждой роли указана почасовая ставка.
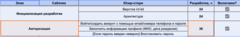 Исходная смета: авторизация и 36 часов
Пример сметы 2026 года. Слева выделен эпик «Авторизация», справа его общая оценка в 36 часов. Это отдельная смета, не медиана всей выборки.
Факт беру из Jira, учет там идет с 28.04.2025. PM время не списывают, поэтому их часы я убрал и из бюджета, и из факта. Под «обычными» дальше понимаю проекты, которые не отнесены к ИИ-first. Это не подтвержденная группа разработки без ИИ: сопоставимой истории трудозатрат до его внедрения у меня нет.
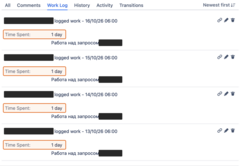 Jira: четыре списания за разные дни
Так выглядит учет фактической работы: четыре списания за 13–16 октября. Каждая запись «1 day» соответствует 8 часам, суммарно 32 часа. Значения сверены с выгрузкой Jira; имена и ключи задач скрыты.
А вот первая проблема с учетом. У сервиса экспедиций в Jira нашлось 311 ч, но примерно 120 ч работы в трекер не попали. Я добавил их к факту. Без этого экономия выглядела бы приятнее, а расчет был бы хуже.
GitLab нужен мне, чтобы проследить участие агентов по коммитам с пометкой Co-Authored-By: Claude в сообщении коммита. Такую служебную пометку называют трейлером. Долю считаю отдельно для каждого репозитория: проекты переходили к агентам в разное время. Сам трейлер говорит только о заявленном соавторстве. Сколько строк написал ИИ и сколько часов сэкономил, по нему не узнать.
Так можно сопоставить ожидания, учтенные часы и историю работы. Для доказательства, что экономию вызвал именно ИИ, этого недостаточно.
До сравнения обозначу границы, чтобы потом не спорить о том, чего эти данные вообще не показывают:
-
Проекты не распределяли случайно между разработкой с агентами и без них. Обычные проекты здесь нужны для проверки попадания в смету, а не для измерения скорости той же работы без ИИ.
-
Со старыми бюджетами сравниваю 2 ИИ-first кейса. Оба веб, оба на Next.js и Nest.js. Это еще не основание раздавать тот же коэффициент мобильным приложениям или всей разработке.
-
80% готовности MVP 1 назвал владелец проекта. Независимой сверки с выполненными задачами у меня нет, поэтому и расчет доли бюджета опирается на эту оценку.
-
Примерно 120 ч у сервиса экспедиций добавлены оценочно. Это поправка на пробел в учете, а не восстановленный до последней минуты табель.
-
PM из сравнения исключены. Здесь считаю часы разработки без управления, поэтому за полную себестоимость проекта результат не выдаю.
-
Архив из 4 910 смет не превращается в такую же выборку по каждой фиче. Сопоставимый ряд здесь только за 2025–2026 годы, размеры выборок указаны в таблицах.
Начал с авторизации. Задача знакомая, но за одинаковым названием в разных продуктах могут стоять разные реализации. В таблице n означает число смет, медиана делит оценки пополам, p25–p75 показывает центральные 50% оценок, а min–max задает границы разброса. Это заложенные часы, до фактических списаний еще дойдем.
Год
n
Медиана
p25–p75
min–max
2025
12
124 ч
64–178 ч
42–373 ч
2026
19
56 ч
24–70 ч
12–189 ч
124 часа против 56: медиана снизилась примерно в 2,2 раза. Причем сдвинулась не только она, меньше стали и квартили, и крайние значения. Для пересмотра старых оценок это уже повод. Но минимальные 12 ч я бы в шаблон для любой авторизации не записывал: сначала надо посмотреть, что входит в конкретную реализацию.
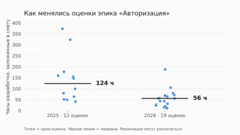 Распределение оценок авторизации за 2025 и 2026 годы
Оценки эпика «Авторизация»: 12 наблюдений за 2025 год и 19 за 2026-й. Каждая точка соответствует одной оценке. Название эпика совпадает, состав реализаций может различаться.
Число часов и цена часа могут меняться независимо друг от друга. Ставку разработки я выписывал из таблицы состава команды: напротив Front-end и Back-end указана почасовая цена. На скриншоте ниже выделены названия ролей и ставки.
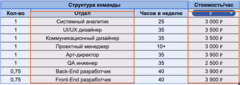 Таблица ролей и почасовых ставок
Пример таблицы состава команды из сметы 2025 года. Выделены роли и соответствующая им цена часа. В этом примере ставки Front-end и Back-end одинаковые: 3 900 ₽/ч.
Год
Оценок со ставкой
Наблюдаемые ставки
Медиана
2025
7
3 900 ₽/ч во всех
3 900 ₽/ч
2026
7
3 300 ₽/ч в трех, 3 600 ₽/ч в одной, 3 900 ₽/ч в трех
3 600 ₽/ч
Ставка тоже снизилась, и это стоит учитывать. Но движение здесь скромнее, чем по часам авторизации. Есть соблазн перемножить две медианы и получить цену фичи. Я этого не делаю: часы и ставки собраны по разным выборкам, а для такого расчета нужны пары значений из одних и тех же смет.
Для внешнего сравнения есть обзор Klerk от 19.06.2025, где senior-ставки отнесены к диапазону 3 000–6 000 ₽/ч. Наши ставки в него попадают, хотя методологию своей выборки обзор не раскрывает и заменить им внутренний ряд я не могу.
Хабр Карьера, январь 2026 сообщает медианную зарплату во второй половине 2025 года 183 333 ₽ против 182 700 ₽ в первой. Здесь речь о месячной зарплате на руки, поэтому напрямую сравнивать ее с биллинг-ставкой было бы ошибкой. Стагнация зарплат согласуется с тем, что цена часа не снизилась резко, но причины изменения наших ставок эти данные не устанавливают.
Со сметами понятно: типовую работу начали оценивать иначе. Но меньше часов в плане еще не означает меньше часов в работе. Пора посмотреть в Jira.
Сравню списанные часы с бюджетом разработки без PM. В последнем столбце факт делю на бюджет: 100% означает, что плановые часы уже потрачены. У ИИ-first проекта работа еще идет, так что его строка промежуточная.
Проект
Тип
Факт / оценка разработки
Отношение
Мобильное приложение с админкой
Обычный
1 359 / 1 360 ч
100%
Продукт о развитии личности
ИИ-first
520 / 515 ч
101%
Проект с ростом скоупа
Обычный
1 880 / 1 031 ч
182%
Еще три обычных проекта дали 85–103%. Источник факта тот же, Jira. PM исключены с обеих сторон.
Вот неудобная для красивого ИИ-кейса строка: 101%. Проект еще идет, а часов уже списали чуть больше, чем планировали. Но оценивали его в мае 2026 года уже с расчетом на ИИ. Если ожидаемую экономию заранее вычли из сметы, попадание в новый план ничего не расскажет о разнице со старым способом работы. Насколько помог ИИ именно здесь, из этих 101% я не узнаю.
«Уложились в смету» хорошо для исполнения плана. А чтобы говорить о продуктивности, мне еще нужно знать, какой объем работы команда выполнила за эти часы.
И строку с 182% я оставил специально. У проекта 23 переоценки и выросший скоуп, а в сравнении по-прежнему стоит исходный бюджет. Объявить такую команду медленной по одному отношению часов было бы странно. Сначала надо разобраться, что именно ей добавили в работу.
Попадание в план само по себе не разделило проекты на быстрые и медленные. Дальше посмотрю на реализации со старыми бюджетами, но перед этим проверю след агентов в GitLab.
В истории коммитов меня интересует пометка Co-Authored-By: Claude. Она помогает увидеть, когда в проекте начали явно отмечать участие агента. Ниже реальное сообщение коммита:
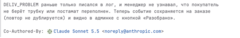 GitLab: сообщение коммита и пометка соавторства
Настоящий скриншот сообщения коммита в GitLab: описание исправления и строка Co-Authored-By: Claude Sonnet 5.5. Имя разработчика и название репозитория за границами кадра. Пометка подтверждает заявленное соавторство, но не измеряет ускорение.
Проект
Период
Доля коммитов с пометкой об ИИ-соавторстве
Сайт косметики
Август–октябрь 2026
92% из 802 коммитов
Сервис экспедиций
Июнь 2026
0%
Сервис экспедиций
Сентябрь–октябрь 2026
Около 100%
Мобильное приложение с админкой
Сентябрь 2025 – июнь 2026
0%
То же приложение
Сентябрь–октябрь 2026
23 из 24 коммитов, затем 30 из 30
У сайта косметики 802 коммита и один разработчик, который их делал. Рабочих дней в этом кейсе 37, пометка агента есть у 92% коммитов. Для меня здесь интересно, как один человек ведет такую разработку с агентами. Но считать эти 92% долей машинных строк или делить на них рабочее время я бы не стал.
У мобильного приложения особенно удобно смотреть переход внутри одного проекта. До июня 2026-го в таблице пометок нет, в сентябре–октябре они почти во всех коммитах. За июль–август данных в этой таблице нет, так что точный месяц перехода оставлю открытым. У сервиса экспедиций похожая смена видна между июнем и осенью.
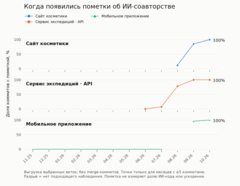 Пометки ИИ-соавторства по месяцам
Доля коммитов с заявленным ИИ-соавторством по месяцам выбранных веток, без merge-коммитов. Показаны месяцы минимум с пятью коммитами. Разрывы означают отсутствие подходящего наблюдения, не нулевое использование ИИ.
Количество коммитов я за производительность не беру: объем работы в каждом может быть разным.
В соседних репозиториях событийного продукта, PDF-сервиса и телекома пометок по-прежнему около 0%. Смешивать их с остальными в одну среднюю я не стал: так потеряется разница между проектами. И назвать их разработкой без ИИ по одному отсутствию трейлеров тоже не могу.
Счетчик видит только коммиты с пометкой. Если разработчик использовал ИИ, но не поставил трейлер, это участие останется за кадром. Поэтому график читаю как историю заявленного соавторства, а за экономией часов возвращаюсь к Jira и объему выполненной работы.
Сначала работа обгоняет смету. Потом смета догоняет работу. Из-за этого большой выигрыш относительно бюджета может исчезнуть именно тогда, когда новый процесс уже учли в оценке.
Сайт косметики и сервис экспедиций оценивали весной 2026 года. Авторизация в тех сметах стоила 36–41 ч, а реализовывали проекты уже с агентами. В продукте о развитии личности на авторизацию заложено 12 ч с расчетом на ИИ. Поэтому одинаковый процент попадания в бюджет здесь означал бы исполнение совсем разных планов.
В этой таблице разворачиваю деление: теперь бюджет делю на фактические часы. 2,5× означает, что бюджет в 2,5 раза больше факта. Бюджеты взяты из смет, факт из Jira с поправкой на неучтенную работу, PM исключены. У незавершенного проекта расчет пока промежуточный.
Проект
Сдано
Часы разработки: факт / бюджет
Бюджет / факт
E-commerce сайт косметики
80% MVP 1, оценка владельца
240 / 594 ч; 594 ч = 80% от исходных 742 ч
Около 2,5×: 594 / 240
Сервис экспедиций
100%
Около 431 / 1 627 ч; 311 ч Jira + примерно 120 ч вне учета
Около 3,8×: 1 627 / 431. Авторское округление: 3×
Продукт о развитии личности
Идет
520 / 515 ч
Около 0,99×: 515 / 520, промежуточный расчет
С сайтом есть допущение, которое заметно влияет на результат. Владелец оценил готовность в 80%, и я условно взял 80% бюджета: 742 × 0,8 ≈ 594 ч. Но 80% готовности не обязательно означают 80% трудоемкости. Сверки сметных часов по конкретным закрытым задачам здесь нет, поэтому и отношение 594 / 240 ≈ 2,5× зависит от этой оценки.
У экспедиций проблема с другой стороны: часть работы не попала в Jira. К 311 ч добавил примерно 120 ч оценочно, получилось около 431 ч. Старый бюджет в 1 627 ч делю на этот факт и получаю примерно 3,8×. Для вывода беру 3×, округляя вниз. Это мой осторожный выбор числа, не статистически доказанная нижняя граница.
А из 101% у продукта о развитии личности вывод «ИИ не помог» тоже не следует. В его бюджет уже заложили другую норму часов. Как изменилось время относительно разработки без агентов, по этой строке не видно.
Во всех трех строках речь о часах разработки. По этим отношениям я не могу сказать, насколько раньше заказчик получил продукт: календарную поставку здесь не сравнивали.
Что я из этого забираю для работы: старые нормы часов стоит перепроверять. Но переносить коэффициент из двух веб-кейсов в обещание для любого следующего проекта я бы не стал. Готовность сайта и пробелы в учете экспедиций никуда из расчета не исчезли.
В сметах на 2027 год я бы начал с пересмотра знакомых задач. Если авторизацию уже оценивают в другие часы, зачем автоматически тащить в следующий проект старую цифру? При этом цена часа менялась скромнее: медиана 3 900 → 3 600 ₽/ч. Данных для обещания, что любые приложения теперь равномерно подешевеют, у меня нет.
Проверить, всегда ли ИИ экономит время, позволяет эксперимент, где доступ к нему распределяли случайным образом и измеряли время выполнения реальных задач. Исследовательская группа METR, 10.07.2025 получила результат с обратным знаком:
when developers use AI tools, they take 19% longer than without—AI makes them slower
В METR 16 опытных разработчиков решали 246 задач в знакомых open-source проектах, а доступ к ИИ распределяли случайно. У меня другое сравнение: агентные реализации 2026 года против смет. Поэтому я не могу поставить свои коэффициенты рядом с их результатом и объявить, что опроверг исследование. Но и их результат не переносится на любой новый проект автоматически. Почему результаты расходятся, эти данные не объясняют.
Экономия на реализации еще оставляет открытым вопрос о затратах на сопровождение: если код придется чаще переделывать, первоначального подсчета часов будет недостаточно. Посмотреть за пределы сдачи проекта заставляют данные о дублировании кода. GitClear, январь 2026, фиксирует рост дублирования с 40,3 (2023) до 73,0 блока на миллион измененных строк (2026, первое полугодие), на 81%. Затраты на дальнейшее сопровождение моих кейсов в этой выборке не измерены, поэтому приписывать им удорожание на основании чужого исследования я бы не стал.
Распространенность ИИ еще не говорит о стабильности поставки. В отчете DORA, сентябрь 2025 ИИ используют 90% опрошенных, а 30% почти или совсем не доверяют его коду. Более активное использование ИИ в отчете связано и с ускорением выпуска изменений, и с ухудшением стабильности поставки. Поэтому к часам разработки придется добавлять наблюдения за тем, как команда поставляет изменения и насколько стабильно это происходит.
Мой вывод пока такой: в оценках знакомых фич часов стало меньше, а в двух агентных реализациях потратили меньше старого бюджета. Этого мне хватает, чтобы пересматривать нормы оценки. Чтобы обещать любому заказчику ускорение в несколько раз, данных недостаточно.
Следом хочу так же посчитать продукт, который один человек делает вместе с агентами. Пока результатов нет. Вот такая вот пока промежуточная картина, но что есть.
Источник: habr.com