
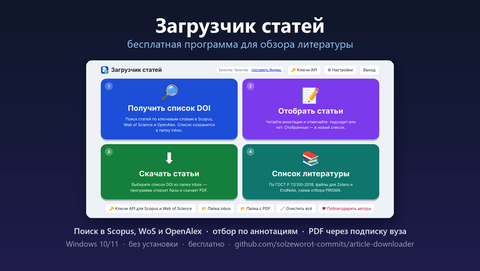
Кто писал обзор литературы, знает этот путь. Один и тот же запрос надо составить для трёх баз, у каждой свой синтаксис. Потом списки склеиваются, из них убираются повторы, прочитываются сотни аннотаций. PDF скачиваются по одному через «Войти через организацию», список литературы оформляется по ГОСТ. В конце нужна схема PRISMA, и цифры для неё приходится собирать задним числом. Почти всё здесь — механическая работа.
Ниже — как автоматизировать каждый шаг с помощью открытых API, с примерами запросов, которые можно проверить у себя. И бесплатная программа для Windows и Mac, в которой это собрано вместе. Я её автор, поэтому об ограничениях честно рассказано в отдельном разделе.
Шаг 1. Один запрос — три базы
У каждой базы свой язык запросов: в Scopus это TITLE-ABS-KEY(...), в Web of Science — TS=(...), в OpenAlex — параметры search и filter. При переписывании запроса легко ошибиться в скобках. Поэтому программа собирает все три запроса из одного списка слов: одно понятие — одна строка, синонимы — через точку с запятой. Синонимы внутри строки соединяются через OR, строки между собой — через AND, словосочетания берутся в кавычки.
Например, для обзора о биоугле из кофейной гущи нужно ввести две строки:
spent coffee grounds; coffee wastebiochar; pyrolysisГоды — 2015–2025, типы — статьи и обзоры. Получается так (переносы строк добавлены для читаемости):
Scopus: TITLE-ABS-KEY(("spent coffee grounds" OR "coffee waste") AND (biochar OR pyrolysis)) AND PUBYEAR > 2014 AND PUBYEAR < 2026 AND (DOCTYPE(ar) OR DOCTYPE(re))WoS: TS=(("spent coffee grounds" OR "coffee waste") AND (biochar OR pyrolysis)) AND PY=(2015-2025) AND DT=(Article OR Review)OpenAlex: search=("spent coffee grounds" OR "coffee waste") AND (biochar OR pyrolysis) filter=from_publication_date:2015-01-01,to_publication_date:2025-12-31,type:article|reviewВсе три запроса видны в окне, перед поиском их можно поправить руками. Дальше программа идёт в API:
-
Scopus Search API. Нужен ключ разработчика Elsevier и доступ организации: запросы должны идти из сети вуза или с институциональным токеном. Если доступа нет, программа так и пишет, а не сообщает «неверный ключ».
-
Web of Science Starter API. У Clarivate есть бесплатный план с жёсткими лимитами на число запросов, поэтому программа делает паузу между страницами выдачи.
-
OpenAlex. Открытая база, бесплатный ключ поднимает лимиты.
Результаты объединяются по DOI без учёта регистра: одна запись — один DOI, источники запоминаются. Программа сохраняет, сколько записей найдено в каждой базе, сколько было повторов и записей без DOI. Эти цифры понадобятся для схемы PRISMA.
Без ключей тоже можно работать, в режиме «через браузер». Программа открывает Scopus или расширенный поиск WoS с подставленным запросом, вы делаете экспорт, и программа сама подхватывает файл из «Загрузок». Она читает экспорт WoS (Plain text и Tab‑delimited) и Scopus (CSV и RIS).
Проверить, хватает ли слов, помогает OpenAlex. Программа берёт 50 самых подходящих работ и считает, какие ключевые слова и темы у них встречаются чаще всего.
OpenAlex можно попробовать и без программы, из командной строки:
curl -G "https://api.openalex.org/works" --data-urlencode 'search=("spent coffee grounds" OR "coffee waste") AND (biochar OR pyrolysis)' --data-urlencode 'filter=from_publication_date:2015-01-01,to_publication_date:2025-12-31,type:article|review' --data-urlencode 'per-page=25' --data-urlencode 'select=doi,title,publication_year'6 ноября 2026 года OpenAlex нашёл по этому запросу 3978 записей. Чтобы выгрузить больше одной страницы, нужен параметр cursor.
Шаг 2. Отбор по названиям и аннотациям
Для отбора нужны аннотации, а в ответе поисковых API их часто нет. Программа бесплатно дозагружает данные по DOI: аннотацию — из OpenAlex, библиографию (авторы, том, выпуск, страницы) — из Crossref. Запросы идут пачками: до 50 DOI за раз в OpenAlex и по 20 — в Crossref.
Первая тонкость: OpenAlex хранит аннотацию не текстом, а «перевёрнутым индексом», то есть словарём «слово → позиции». Текст собирается обратно так:
def abstract_from_inverted_index(inv: dict) -> str: words = sorted((pos, word) for word, positions in inv.items() for pos in positions) return " ".join(word for _, word in words)Вторая тонкость: у статей Elsevier аннотаций в OpenAlex нет, издатель их не отдаёт. Для таких статей программа ищет аннотацию в Europe PMC. Это помогает с работами, которые индексирует PubMed, но не со всеми.
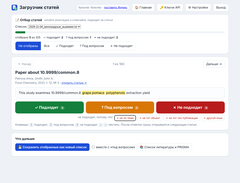
Сам отбор устроен так: на экране одна статья, слова из запроса подсвечены, решение принимается клавишей. 1 — подходит, 2 — под вопросом, 3 — не подходит. Для исключённых статей есть кнопки причин: «не по теме», «не тот объект», «не тот тип публикации», «другой язык». Решения сохраняются, из отобранных статей можно сделать новый список. Снимок ниже сделан на тестовых данных.
Шаг 2½. Что пропустил поиск: ссылки и отозванные статьи
Поиск по ключевым словам всегда что‑то упускает: статья может называться иначе или использовать другие термины. В систематических обзорах поэтому делают «снежный ком»: смотрят, на какие работы ссылаются уже отобранные статьи и какие работы ссылаются на них. OpenAlex отдаёт и то и другое бесплатно.
Найти статью по DOI и узнать её идентификатор и список литературы:
curl "https://api.openalex.org/works/doi:10.1136/bmj.n71?select=id,referenced_works,cited_by_count"Кто на неё ссылается (самые цитируемые первыми; W… — идентификатор из ответа выше):
curl -G "https://api.openalex.org/works" --data-urlencode 'filter=cites:W3118615836' --data-urlencode 'sort=cited_by_count:desc' --data-urlencode 'select=doi,display_name,publication_year'Программа делает это для всех статей, отмеченных «подходит». Кандидаты ранжируются по тому, со сколькими отобранными статьями они связаны: работа, на которую ссылаются пять ваших статей, почти наверняка важна. Добавленные так статьи попадают в отбор и в схеме PRISMA считаются отдельной строкой: «найдено по ссылкам».
Вторая находка — отозванные статьи (retracted). Журналы иногда отзывают работы из‑за ошибок или подлога, а сослаться на такую в диссертации неприятно. В OpenAlex у каждой работы есть поле is_retracted:
curl "https://api.openalex.org/works/doi:10.1016/S0140-6736(97)11096-0?select=display_name,is_retracted"Это известная статья Wakefield (Lancet, 1998), отозванная в 2010 году: ответ — "is_retracted": true. Программа проверяет так все статьи списка и помечает отозванные красным в отборе и в списке литературы.
Шаг 3. PDF через подписку вуза
Самый утомительный шаг — скачать полные тексты, на которые у вуза есть подписка. Программа делает это через отдельный браузер с собственным профилем: Яндекс.Браузер, Edge или Chrome, смотря что установлено. Управляет она им через Chrome DevTools Protocol (Playwright).
Как это выглядит:
-
Один раз вы входите на сайты издательств через «Войти через организацию» (Shibboleth / OpenAthens). Вход сохраняется в профиле этого браузера.
-
Перед скачиванием программа открывает вкладки издательств: ScienceDirect, SpringerLink, Nature, Wiley, ACS, Taylor & Francis, Oxford Academic, MDPI, Frontiers, CNKI и eLIBRARY.RU. Потом ждёт, пока на них не останется проверок «вы не робот». Капчу проходите вы сами, программа её не обходит.
-
Дальше статьи скачиваются по одной, можно отойти от компьютера. Если проверка выскочит посреди работы, программа покажет предупреждение и подождёт. Статья, которую так и не удалось открыть, уходит в конец очереди.
Важно про нагрузку и условия подписок. По умолчанию между статьями пауза 10 секунд, а в день — не больше 300 попыток. Это не формальность. Во многих лицензиях издательств массовое автоматическое скачивание запрещено, и за нарушение издательство может закрыть доступ всему вузу. Скачивайте то, что действительно нужно для обзора, и уточните правила в своей библиотеке.
Итог записывается в файл «Отчёт.csv»: что скачано, а что нет.
Шаг 4. Список литературы и схема PRISMA
ГОСТ Р 7.0.100–2018 оформляется встроенным модулем, без интернета. Правила такие:
-
при одном‑трёх авторах первый стоит в заголовке, а все — после косой черты; при четырёх все стоят после косой черты; при пяти и больше — первые три и «[и др.]» / «[et al.]»;
-
обозначения русские или английские: Т./Vol., №/No., С./P.;
-
там, где у статьи вместо страниц номер, ставится номер статьи;
-
сначала идут русские источники, потом на латинице.
Встроены и другие стили: APA 7, Vancouver, IEEE, ACS, Chicago, Nature, Elsevier Harvard. Для стиля конкретного журнала используется приём, о котором многие не знают: doi.org сам оформляет ссылку в любом из стилей Citation Style Language. Их около 11 тысяч, те же, что в Zotero и Mendeley. Достаточно указать нужный формат в заголовке Accept:
curl -LH "Accept: text/x-bibliography; style=apa; locale=en-US" https://doi.org/10.1136/bmj.n71Ответ:
Page, M. J., McKenzie, J. E., Bossuyt, P. M., Boutron, I., Hoffmann, T. C., Mulrow, C. D., Shamseer, L.,Tetzlaff, J. M., Akl, E. A., Brennan, S. E., Chou, R., Glanville, J., Grimshaw, J. M., Hróbjartsson, A.,Lalu, M. M., Li, T., Loder, E. W., Mayo-Wilson, E., McDonald, S., et al. (2021). The PRISMA 2020 statement:an updated guideline for reporting systematic reviews. Bmj, n71. https://doi.org/10.1136/bmj.n71Обратите внимание на «Bmj». Оформление получается настолько хорошим, насколько хороши метаданные в Crossref, поэтому готовый список стоит просмотреть глазами.
Список сохраняется в.txt и.docx (с курсивом), а для менеджеров ссылок — в.ris (Zotero, EndNote) и.bib (LaTeX).
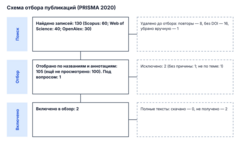
Схема PRISMA. Цифры для неё программа собирает по ходу работы: — сколько записей найдено в каждой базе; — сколько было повторов и записей без DOI, сколько убрано вручную; — сколько статей исключено на отборе и по каким причинам; — сколько полных текстов скачано и сколько получить не удалось.
В конце получается упрощённая схема по образцу PRISMA 2020: на экране, текстом и картинкой PNG. Снимок ниже сделан на тестовых данных.
ИИ‑помощник — по желанию
Всё описанное выше работает без ИИ. При желании можно подключить помощника на своём ключе одного из сервисов: Perplexity, ChatGPT, Claude, GigaChat или YandexGPT. Ключ хранится только на вашем компьютере, деньги за запросы списывает сам сервис, программа показывает, сколько потрачено.
Что умеет помощник:
-
Подбирает слова для поиска. Тему, описанную своими словами, он превращает в 2–4 понятия, у каждого до шести английских синонимов. Они сразу встают в поле ключевых слов в формате из шага 1.
-
Делает предотбор. Читает аннотации пачками по 10 и советует «подходит / под вопросом / не подходит» с причиной. Совет остаётся советом: решение в отборе не меняется, пока вы его не примете.
-
Переводит название и аннотацию на язык интерфейса.
-
Собирает таблицу по статьям для Excel. Читает текст скачанных PDF (или аннотации, если PDF нет) и заполняет столбцы. По умолчанию это объект, метод, условия и главные результаты, столбцы можно поменять.
-
Предлагает план обзора: 4–8 разделов, раскладывает по ним отобранные статьи и пишет, чего не хватает в литературе. Это черновик, а не готовый текст.
В сервис уходят тема, названия и аннотации, а для таблицы — ещё и текст PDF, без списка литературы.
Как это устроено
Для тех, кому интересно, что внутри:
-
Python 3.13 поставляется вместе с программой: на Windows — официальная сборка CPython из NuGet, на Mac — сборки python‑build‑standalone сразу для Apple silicon и Intel. Ничего не нужно устанавливать: архив распаковывается в любую папку.
-
Окно программы — HTML‑страница. Её отдаёт локальный сервер на 127.0.0.1, и каждый запрос к нему проверяется по токену. Открывается страница в Edge в режиме приложения.
-
Ключи API лежат в профиле пользователя Windows. В окне видны только последние четыре символа ключа, в журналы ключи не пишутся.
-
Каждое изменение собирается и проверяется в GitHub Actions на Windows и на macOS: распаковка, запуск, тесты, автообновление, браузер. На странице релиза указана контрольная сумма SHA-256 архива.
Ограничения
-
Windows 10 и 11; версия для Mac — бета: она собирается и проверяется автоматически, но отзывов живых пользователей пока мало. На Mac при первом запуске нужно нажать «Всё равно открыть» в настройках безопасности: подписи Apple у программы нет.
-
У программы нет цифровой подписи, поэтому при первом запуске Windows SmartScreen предупредит о неизвестном издателе. Исходный код можно посмотреть на GitHub, а архив — сверить по контрольной сумме.
-
Скачиваются только полные тексты, на которые есть подписка у вашей организации. Для Scopus API тоже нужен доступ организации.
-
Аннотации есть не у всех статей (см. выше про Elsevier).
-
ИИ ошибается и в синонимах, и в предотборе, поэтому решения остаются за вами.
-
Лицензия: пользоваться и делиться официальным архивом можно свободно и бесплатно, менять программу для себя тоже можно. Продавать её и распространять изменённые версии без разрешения автора нельзя. Иначе говоря, код открыт для чтения, но это не open source в строгом смысле.
Попробовать
Скачать: https://github.com/solzeworot‑commits/article‑downloader (архив для Windows около 55 МБ, для Mac — около 140 МБ, на странице релиза есть инструкция). Вопросы и ошибки: чат в Telegram https://t.me/ArticleDownloaderChat или Issues на GitHub.
Интересно услышать в комментариях: какие шаги литобзора отнимают у вас больше всего времени и каких баз или издательств не хватает?
Источник: habr.com