
Я всегда общалась с ИИ на английском, разве что мне надо было составить какое-то очень специфическое сообщение, или вообще перевести мой текст на испанский. Для меня это языковая практика, да и в целом на темы программирования проще общаться на английском, чтобы не переводить на русский термины. Сейчас я работаю над тем, как эффективнее ставить задачи агенту и предоставлять ему нужные инструкции. И меня заинтересовал вопрос, влияет ли используемый язык на то, как агент решает задачу. Я проводила исследование, чтобы понять, стоит ли переводить истории worklore (это мой проект: библиотека историй разработчиков, которые агент может воспроизвести), чтобы большему количеству людей было комфортно их читать и при этом качество работы агентов, которые следуют историям, не менялось.
Я выбрала шесть задач, сформулировала их на английском и на русском, с заметкой об аналогичном решении и без нее, семь конфигураций агентов, по пять прогонов на ячейку, 1050 прогонов. Потом я добавила две модели Kimi, ещё 300 прогонов: многим в России Claude недоступен, и им важно знать, что взять вместо него. Метод описан в конце статьи.
Если не вдаваться в подробности
-
По-русски агент решает примерно так же. Без заметки прошли 62,6% прогонов с английской задачей и 54,4% с русской. На таком числе прогонов разница в 8 пунктов на грани случайной. Заметно теряют только агенты, которые по-русски перестают искать (об этом дальше).
-
Заметка помогает одинаково на обоих языках. При работе с англоязычными задачами она подняла долю успешных решений на 33 пункта, с русскоязычными на 39.
-
Перевод заметки почти ничего не дал. Нет разницы, на каком языке будут те инструкции, которые найдет агент, для решения задачи.
-
Два агента перестали искать подсказки в интернете. Codex искал в трети прогонов с англоязычной задачей и ни в одном с русской. На задаче, возможное решение которой есть только на форуме, это стоило ему падения оценки с 5 из 5 до 0 из 5, а добавление заметки вернуло 5 из 5. Kimi K3.1 по-русски тоже перестала искать, и на второй форумной задаче её оценка упала так же, с 5 из 5 до 0 из 5.
Если вы работаете не на английском, запомнить стоит четвёртый пункт: агент может молча пропускать шаг поиска решения в интернете, который для англоязычного промпта делает. При этом, если дать ему в промпте заметку с нужным для решения фактом, результаты на обоих языках одинаковы.
Заметка помогает одинаково на обоих языках
Девять конфигураций × пять повторов. На картинке процент успешного решения задачи
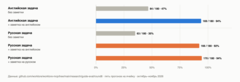
Заметками служили шесть историй из worklore: четыре, в которых есть то, чего у агента нет, и две контрольные, где факт лежит в документации или в логе. В каждой строке 45 прогонов: девять конфигураций по пять повторов.
История
Задача EN
EN + заметка
Задача RU
RU + заметка EN
RU + заметка RU
Пульсовой коридор для часов Garmin (факт с форума, в документации нет)
32/45
45/45
19/45
44/45
45/45
Отложенный запуск не работает по двум причинам (одну из них без подсказки не починить)
10/45
42/45
11/45
41/45
42/45
Три особенности OAuth-провайдера (факт с форума)
22/45
40/45
16/45
40/45
40/45
Событие аналитики на каждое нажатие (ловушка там, где пишется код)
20/45
42/45
17/45
41/45
43/45
Два маркера кеша для записи в память (контроль: факт из документации)
42/45
44/45
40/45
43/45
43/45
Падение DynamoDB на второй записи (контроль: причина в логе)
43/45
44/45
44/45
44/45
45/45
всего
169/270
257/270
147/270
253/270
258/270
На четырёх историях, где в заметке был факт, которого у агента нет, доля успехов выросла с 47% до 94% при английской задаче и с 35% до 92% при русской. По всем шести историям прирост от заметки 33 пункта на английском и 39 на русском; разница двух приростов 7 пунктов с 95-процентным интервалом от минус 3 до плюс 16. Заметка помогает на любом языке.
На контрольных историях заметка почти ничего не меняла: от 40 до 45 из 45 во всех вариантах, на обоих языках.
Перевод заметки почти ничего не дал
Последние две колонки таблицы — это одна и та же заметка на разных языках. Задача по-прежнему ставилась на русском. Перевод набрал на 2 пункта больше оригинала, интервал от минус 2 до плюс 6. Все конфигурации, кроме GPT-OSS, с заметкой на любом языке были на уровне 29 или 30 из 30.
Причина видна в логах: агент цепляется за идентификаторы, пути и тексты ошибок, а они в переводе остались английскими, потому что так они выглядят в коде. В этом эксперименте перевод заметок агентам не помог, так что ради них я бы на него время не тратила.
Язык задачи почти ничего не меняет
Без заметки по всем задачам и конфигурациям с русской задачей результат снизился на 8 пунктов, интервал от минус 16 до нуля, то есть разница на грани случайной. Заметно просели только три конфигурации: оба Codex и Kimi K3.1. У остальных шести разница не больше двух прогонов из 30. Эти три по-русски перестают искать в интернете, и на них приходится почти вся разница между языками. Об этом следующий раздел. По конфигурациям, 30 прогонов:
Конфигурация
Задача на английском
Задача на русском
Claude Opus 5.5
27/30
27/30
Claude Sonnet 5.5
22/30
23/30
Claude Haiku 5.5
19/30
17/30
Codex GPT-6-Sol medium
21/30
17/30
Codex GPT-6-Sol low
20/30
12/30
Gemini 3.8 Flash
17/30
17/30
GPT-OSS 120B
6/30
5/30
Kimi K2.8 Preview
19/30
17/30
Kimi K3.1 Pro
18/30
12/30
Ответы от Claude, Codex, Gemini и Kimi приходили по-русски, а имена переменных и прочие термины, как и ожидалось, оставались на английском. GPT-OSS отвечал по-английски, на каком языке ни спроси.
Где появилась разница: поиск в интернете
Без заметки в промпте, шесть задач × пять повторов. Слева: прогоны хотя бы с одним поиском или запросом в интернет. Справа: прогоны, прошедшие Verify.
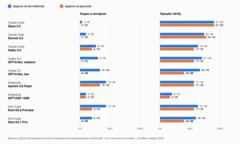
Я предполагала, что задача, сформулированная на русском может помешать агенту находить ответ на английском. Так и вышло для двух агентов — Codex и Kimi K3.1: по-русски они перестали искать, а другого пути к ответу у них не было. То, что язык запроса меняет то, как агент в Codex на него реагирует, меня удивило.
Посмотрите ещё раз на первую строку таблицы историй. История про пульсовой коридор — место, где русская задача сильнее всего снизила результат: 32 из 45 против 19 из 45. Это больше половины всей разницы между языками в этом раунде. С английской задачей Codex-low каждый раз делал один и тот же запрос, site:forum.intervals.icu workout_doc hr units %lthr …, находил формат и проходил 5 из 5. С русской задачей он ни разу не открыл интернет и вместо этого придумывал формат сам: один раз убрал структурированную цель совсем, два раза перешёл на абсолютные удары в минуту со значением и диапазоном, один раз оставил старый ключ и добавил рядом новые. На вид это правдоподобные исправления, но ни одно не совпало с форматом, который понимают часы: 0 из 5. Codex на среднем reasoning на той же истории упал с 3 из 5 до 0 из 5, а история про особенности OAuth, второй форумный факт, показывает ту же картину слабее: по всем конфигурациям искали 27 из 45 английских прогонов и 11 из 45 русских.
У Kimi K3.1 то же самое случилось на истории про OAuth. С английской задачей она в четырёх прогонах из пяти искала на forum.intervals.icu и прошла 5 из 5. С русской ни разу не открыла интернет и прошла 0 из 5: в четырёх прогонах оставила повторяющиеся области в scope, в трёх оставила проверку срока жизни токена, хотя токены у этого провайдера не истекают. С заметкой 5 из 5 на обоих языках.
Модели Claude на этих задачах почти не ищут ни на каком языке: формат коридора они берут из файлов readback в самом проекте, поэтому у Opus и Sonnet результат на двух языках одинаковый. Gemini Flash ищет на обоих языках, до 75 обращений к интернету за прогон, и на задаче про коридор проходит на обоих, но там ему помогал сам Google: в каждом прогоне, который можно проверить, поиск вернул историю с worklore. Разница появилась там, где без заметки ответ можно было найти только поиском, а Codex и K3.1 с русской задачей этим поиском не пользовались. Почему язык задачи меняет это поведение, я не проверяла.
С заметкой в промпте поиск прекращается на любом языке: от нуля до двух прогонов на ячейку. Заметка заменяет поиск. Так что если у вас есть хорошая база знаний по потенциальным проблемам проекта, дайте ее агенту, ему так будет проще.
Что выбрать, если Claude недоступен
Для тех, у кого нет Claude, я прогнала те же задачи в Kimi Code, CLI-агенте от Moonshot AI, на двух моделях: K2.8 Preview, которая стоит там по умолчанию, и K3.1 Pro. Те же шесть задач, те же пять вариантов, по пять повторов, 300 прогонов. Ниже все девять конфигураций, по 30 прогонов в ячейке (русская задача без заметки в таблице выше); время в последней колонке для русской задачи с англоязычной заметкой.
Конфигурация
Задача EN без заметки
EN + заметка
RU + заметка EN
Секунд на прогон
Claude Opus 5.5
27/30
29/30
29/30
85
Claude Sonnet 5.5
22/30
30/30
30/30
28
Claude Haiku 5.5
19/30
30/30
30/30
61
Codex GPT-6-Sol medium
21/30
30/30
30/30
86
Codex GPT-6-Sol low
20/30
30/30
30/30
43
Gemini 3.8 Flash
17/30
30/30
30/30
83
GPT-OSS 120B
6/30
18/30
14/30
79
Kimi K2.8 Preview
19/30
30/30
30/30
252
Kimi K3.1 Pro
18/30
30/30
30/30
176
С заметкой обе модели Kimi прошли 30 из 30 во всех трёх вариантах, как Sonnet, Haiku, оба Codex и Gemini Flash. Без заметки с английской задачей они на уровне Haiku. Различаются они в двух местах. K2.8 по-русски продолжает искать в интернете и без заметки теряет меньше: 17 из 30 против 12 у K3.1. Зато K3.1 почти в полтора раза быстрее, 176 секунд на прогон против 252, а у K2.8 два прогона без заметки упёрлись в лимит 20 минут и засчитаны как провал. Обе медленнее остальных: Codex на низком reasoning тратил в том же варианте 43 секунды, Sonnet 28.
Если Claude нет, я бы взяла K3.1 и подробнее описывала задачу: с заметкой она прошла 30 из 30 и работает быстрее. Без заметки с русской задачей надёжнее K2.8, но и у неё это 17 из 30. GPT-OSS 120B, открытой модели, которую можно запустить у себя, даже с заметкой хватило только на 14–19 из 30.
Не сказать, что результат поменял для меня что-то — меня Claude вполне устраивает и менять на что-то другое я его не собираюсь. Тем не менее, знать, что что-то пойдет не так из-за формулировки — важно.
Что из этого следует
-
Пишу задачи по-английски, если их может получить Codex или Kimi K3.1. Остальным агентам язык почти не важен, но эти два по-русски перестают искать в интернете, и если ответ есть только на форуме, они его не находят.
-
Даю агенту факт, если он у меня есть. Агент и сам поищет, еще и в соседние папки залезет, если ему разрешить, но если корректное решение известно заранее, лучше его упомянуть.
-
Не перевожу заметки. Англоязычная заметка сработала не хуже русскоязычной. Важны идентификатор, путь и текст ошибки, а они и так не переводятся.
-
Если вашего агента нет в этой таблице, проверьте его. Дайте ему одну задачу, ответ на которую есть только в интернете, один раз по-английски и один раз на своём языке, и посмотрите в логе команд, искал ли он. Если на своём языке не искал, ставьте ему задачи по-английски или давайте нужный факт в промпте.
Как я проверяла
Каждая задача: маленький репозиторий с одной заложенной проблемой и просьба в одно-два предложения, как её набрал бы человек. Пять вариантов:
-
английская задача без всего;
-
английская задача плюс заметка: история с worklore, поданная как «заметка коллеги о похожем случае: используй то, что подходит, и напиши, какие части пригодились»;
-
русская задача без всего;
-
русская задача плюс англоязычная заметка;
-
русская задача плюс заметка, переведённая на русский.
Семь конфигураций: Claude Code с Opus, Sonnet и Haiku 5.5; Codex CLI с GPT-6-Sol на среднем и низком уровне reasoning; Antigravity с Gemini 3.8 Flash и GPT-OSS 120B. Позже к ним добавились две модели в Kimi Code 2.5.2: K2.8 Preview, которая стоит там по умолчанию, и K3.1 Pro. У всех был доступ в интернет, не было памяти, файлов инструкций и MCP-серверов. Результат оценивал скрытый скрипт по разделу Verify истории: он смотрел репозиторий, дифф и лог команд, но не отчёт агента о себе. По пять повторов на ячейку, поэтому выше интервалы, а не одиночные числа; 95-процентные интервалы посчитаны методом bootstrap по прогонам.
Ограничения
Шесть задач, один неанглийский язык, в каждом репозитории одна заложенная проблема. Пяти повторов на ячейку (45 прогонов на историю) хватает на интервалы выше и не хватает, чтобы ранжировать конфигурации между собой. Русские тексты переведены моделью и проверены мной; код и идентификаторы в историях оригинальные. Видела ли модель историю при обучении, я проверить не могу. Из интернета её доставали: в 30 прогонах без заметки агент увидел саму историю на worklore (Codex, Gemini Flash, GPT-OSS и обе Kimi, всё на двух форумных задачах). Для Gemini Flash её находил сам поиск Google: он пересказывал решение своими словами и ставил worklore.dev источником, даже когда агент искал только по форуму Intervals.icu. Прошли 24 из 30. Если их выбросить, доля успехов без заметки падает с 62,6% до 60,6% на английской задаче и почти не меняется на русской (54,4% и 54,1%), и выводы те же. Но у Gemini Flash на задаче про пульсовой коридор чистых прогонов без заметки не остаётся вовсе, а у K2.8 на той же задаче все шесть успехов без заметки пришли оттуда. Kimi шла почти на две недели позже остальных и в песочнице: без доступа к домашней папке, launchctl и связке ключей, потому что её вывод уходит в Moonshot. Для задачи про ночное задание в репозитории лежит сохранённый вывод launchctl, но небольшое влияние песочницы я исключить не могу.
Всё лежит на GitHub: тестовые репозитории с заложенными проблемами, промпты на обоих языках, скрипты оценки и логи каждого прогона, в worklore-mcp/research/guide-eval/round8. Заметки это истории на worklore, у каждой есть раздел Verify и счётчик агентов, которые её воспроизвели.
Источник: habr.com