
Поиск по смыслу плохо различает «открыто» и «не открыто»: векторы почти совпадают, потому что тема одна и та же. В словах это знают все, а вот насколько это системно и можно ли починить без дообучения, мне хотелось проверить на данных.
Идея простая. В word2vec есть знаменитое king − man + woman ≈ queen: «пол» оказывается почти линейным направлением. Есть ли такое «направление негации» в финальных эмбеддингах моделей, то есть в тех векторах, по которым реально ищут? И если есть, можно ли одной такой осью лечить слепоту к отрицанию?
Как я проверял
-
Метод DiffMean: для каждой пары «утверждение / то же с отрицанием» считаю разность эмбеддингов, усредняю по 240 парам на язык. Получается ось
v_neg. -
Контрольные направления, чтобы не обмануться: вставка нейтрального наречия, замена на антоним, разность случайных фраз, тема.
-
8 моделей, 11 пар «модель × язык» (6 английских, 5 русских): all-mpnet-base-v2, bge-base-en-v1.5, e5-base-v2, multilingual-e5-base, paraphrase-multilingual-MiniLM-L12-v2, bge-m3, rubert-tiny2, USER-base. Смотрел все слои энкодера, а не только выход.
-
Критерии подтверждения гипотез записал до расчётов, вердикты выставляет скрипт. Журнал решений лежит в репозитории.
Что получилось
-
Направление есть и оно устойчивое. Если считать ось по двум непересекающимся половинам данных, векторы совпадают с косинусом 0,87–0,95 (шум даёт около нуля). Это выполняется для всех 11 пар «модель × язык».
-
Это не «любая правка» и не тема. От вставки нейтрального наречия ось отличается (косинус около нуля), и в подпространство тем попадает лишь 0,6–4,8% квадрата её нормы.
-
Но на выходе это не чистая негация. Если посчитать ось отдельно на позитивных («совещание было продуктивным») и на негативных утверждениях («гости были грубыми»), в английских моделях они смотрят в противоположные стороны (косинус от −0,29 до −0,55). «Не хороший» сдвигается к «плохой», а «не грубый» к «вежливый»: ось сильно перекрывается с направлением «замена на антоним» (0,48–0,84 после поправки на шум). На ранних и средних слоях этого нет, переворот происходит в последней трети сети. В русском эффект слабее и есть не во всех моделях.
-
Если уравнять позитивные и негативные утверждения по весу, остаётся устойчивая компонента (0,86–0,95), почти не связанная с тональностью. Она находит отрицание в живых фразах из STS-B с AUC 0,89–0,99 и совпадает для английского «not» и русского «не» внутри мультиязычных моделей (косинус 0,90–0,95).
Можно ли этим пользоваться
Я проверил на отложенных тройках «якорь, правильный ответ, ловушка».
-
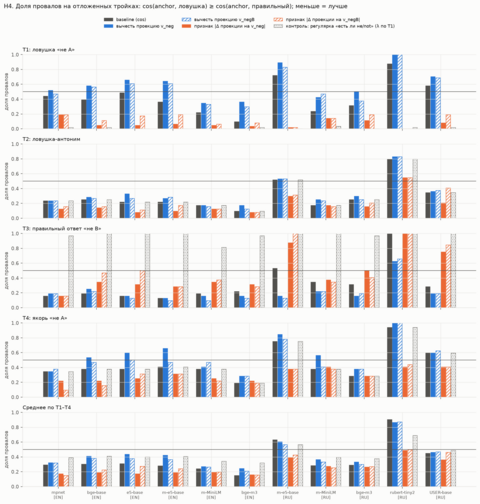
Вычитать ось из эмбеддингов не стоит. «X» и «не X» становятся ещё ближе, основной тип ошибок ухудшается у 11 из 11 моделей (значимо у 10).
-
Добавлять как признак к косинусу работает:
cos(a, c) − λ·|a·v_neg − c·v_neg|, λ подбирается кросс-валидацией. Доля случаев, где «не X» оказывается ближе перефраза, падает, например, с 0,48 до 0,05 (e5-base-v2) и с 0,72 до 0,02 (multilingual-e5-base на русском). В среднем по четырём типам ловушек результат лучше у 10 из 11 моделей. -
Цена: признак штрафует правильные ответы, которые сами содержат отрицание («не закрыто» при якоре «открыто»). Этот тип ухудшается у 9 из 11 моделей, значимо у 2. Простая регулярка «есть ли в тексте not/не» не справляется ни с этим, ни с остальным.
 Доля ошибок поиска на тройках «якорь, правильный ответ, ловушка» (меньше — лучше). Вычитание оси негации (синий) в целом вредит, добавление её как признака к косинусу (оранжевый) помогает на ловушке «не A», но портит случай, где правильный ответ содержит отрицание
Методическая ловушка
Часто проверяют устойчивость так: считают направление по 4/5 данных в каждом из 5 фолдов и сравнивают фолды между собой. Но такие фолды делят 3/5 данных, поэтому даже чистый шум даёт около 0,7, а 99-й перцентиль нуля доходит до 0,92–1,00. Наивный порог «больше 0,7–0,8» проходится автоматически. Нужны непересекающиеся половины и нулевое распределение со сменой знака.
Ограничения (важно)
-
Короткие шаблонные фразы: 48 утверждений на язык, только явная частица «не»/not. «Никогда», «нет», морфологическое отрицание и длинные документы не проверялись.
-
Отложенный набор для практической части небольшой (64 пункта на язык), λ подбирается кросс-валидацией на нём же. Внешнего бенчмарка пока нет.
-
Тональность и антонимы размечал один автор. Сбалансированная ось добавлена после просмотра данных (post hoc).
-
Только DiffMean, линейные классификаторы и LEACE не сравнивались.
Код, данные, все таблицы и отчёт: github.com/makltd123/negation-direction. Направления для каждой модели и слоя лежат в artifacts/v_neg/, воспроизведение занимает около 35 минут на 4-ядерном CPU.
Источник: habr.com