
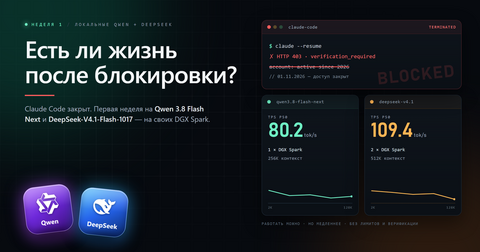
TL;DR. Anthropic в очередной раз заблокировал мой аккаунт, и Claude Code стал недоступен. Я попробовал заменить его локальными Qwen 3.8 Flash Next (1 × DGX Spark) и DeepSeek-V4.1-Flash-1017 (2 × DGX Spark). Замеры TPS/TTFT, рабочий процесс с двумя моделями и вывод — работать можно, но цикл разработки стал занимать значительно больше времени.
Железо для экспериментов выделил работодатель — компания, которая сдаёт DGX Spark в аренду. Статья — личный опыт, не реклама.
Что случилось
Очередная волна блокировок со стороны Anthropic зацепила и меня — как и многих других пользователей из РФ. 1 ноября 2026 года при входе в Claude Code мне предложили пройти верификацию. За пару дней до этого с той же проблемой столкнулись многие мои знакомые разработчики, и всех их в итоге заблокировали после верификации. Я решил не отдавать паспортные данные и сразу перейти к стадии принятия: смириться с потерей и жить дальше.
Морально я давно готовился к этому моменту, но, как показала практика, всё же не был до конца готов. Ощутил пустоту: потерял очень удобный инструмент, к которому привык за восемь месяцев. За это время случилась уже третья блокировка. Возможно, через месяц попробую завести новый аккаунт, но пока подожду: пусть пыль уляжется.
Но, вместе с этим, также получил и некое облегчение — больше не нужно думать, на что потратить неизрасходованные недельные лимиты.
Что я пробую
Ну, а пока нужно пробовать альтернативы. Собрал фидбек от знакомых разработчиков, которых тоже заблокировали за несколько дней до этого. Разумеется, они попробовали те же варианты, о которых думал и я, — Kimi K3.1 и Codex, — но разочаровались в них. Поэтому я выбрал другой путь — локальные китайские модели с открытыми весами.
Я давно интересуюсь локальными LLM (о чём упоминал в прошлой статье), и как раз сложились условия, чтобы проверить их в реальной работе. Организация, в которой я работаю, сдаёт в аренду NVIDIA DGX Spark. В рамках расширения парка компания закупила ещё два DGX Spark, которые мне временно выделили под эксперименты. Ещё один DGX Spark раньше выделили команде — на нём уже больше месяца работает Qwen 3.8 Flash Next. Команда хорошо отзывается об этой модели.
Qwen развёрнут по рецепту Qwen3.8-Flash-Next-Single-DGX-Spark-TensorFold.
В первый день после блокировки решил развернуть DeepSeek-V4.1-Flash-1017 (EXL3) по рецепту для кластера из двух Spark. Поскольку Spark’и выделяют мне временно и, скорее всего, периодически они будут снова попадать в мои руки чистыми, я решил автоматизировать подготовку и деплой с помощью Ansible. Разведку машин, сбор требований, написание плейбуков и их прогон выполнял Qwen 3.8 Flash Next, запущенный на соседнем Spark. Это заняло примерно один рабочий день. Qwen работал долго, зато автономно — мне почти не приходилось вмешиваться. С работой он справился отлично: DeepSeek запустился с первой попытки.
На второй день начал использовать обе модели в реальных задачах: PHP (Symfony), Go и инфраструктура на K8s. В качестве основного harness (обвязки) пока использую минималистичный Pi, установленный в WSL. Пока у меня был доступ к Claude Code, я сделал плагин-обёртку для консольного Pi в PhpStorm. Через этот плагин работать гораздо удобнее, чем в терминале: можно вставлять скриншоты прямо в окно чата и легко поставить курсор в нужное место мышью. Использую расширение pi-subagents, чтобы экономить контекст основной сессии.
Конфигурация
Параметр
Qwen 3.8 Flash Next
DeepSeek-V4.1-Flash-1017
Железо
1 × DGX Spark
2 × DGX Spark
Движок
TensorFold
TensorFold
Квантизация
по рецепту TensorFold
EXL3 (ExLlamaV3)
Контекст
256K
512K
Развёртывание
рецепт TensorFold
рецепт для 2 × Spark + Ansible
Reasoning
xhigh / medium
high / medium
Temperature
0.7 / 0.6
0.7 / 0.6
Бенчмарки
Методика
Написал небольшой бенчмарк, чтобы видеть ключевые показатели, которые модели выдают на этом железе. Делал по 10 замеров на каждом размере контекста: 2K, 8K, 32K, 64K и 128K. Профиль — code, на выходе 256 токенов, temperature 0, thinking off. Перед каждой серией делается один прогревочный запрос — в замеры он не попадает. Промпты в замерах уникальные: в начале стоит случайный salt, поэтому кэш префикса не помогает — это честный холодный prefill. Считал TPS (скорость генерации), TTFT p50 (медиану времени до первого токена) и разброс TTFT min–max. Ещё считал prefill — скорость разбора промпта, то есть prompt_tokens / TTFT p50.
Отдельно про выбросы: в данных есть запросы с TTFT 4,8 с на 2K и 10,2 с на 8K у DeepSeek — похоже на разовые выбросы планировщика или кэша. Поэтому в таблицах я даю не только p50, но и min–max: медиана показывает типичный случай, а разброс — насколько всё может прыгать.
Qwen 3.8 Flash Next
Контекст
prompt tokens (median)
TPS p50 (min–max)
TTFT p50, с
TTFT min–max, с
prefill, ток/с
2K
2125
80.2 (67.0–87.0)
0.94
0.94–0.97
2256
8K
8282
74.0 (60.2–89.4)
3.29
3.28–3.32
2515
32K
32796
74.8 (35.4–89.3)
13.05
13.04–13.43
2514
64K
65598
70.7 (33.7–89.6)
26.90
26.84–27.00
2438
128K
130931
72.6 (58.5–86.5)
56.94
56.73–57.01
2299
DeepSeek-V4.1-Flash-1017
Контекст
prompt tokens (median)
TPS p50 (min–max)
TTFT p50, с
TTFT min–max, с
prefill, ток/с
2K
2113
109.4 (83.2–117.1)
1.25
1.21–4.76
1693
8K
8320
107.7 (82.6–117.8)
3.90
3.87–10.19
2133
32K
32893
105.2 (89.7–118.0)
14.54
14.52–20.88
2262
64K
65607
106.0 (90.3–117.2)
35.51
33.24–35.57
1848
128K
130867
98.9 (72.1–116.4)
73.01
66.77–73.45
1793
Что видно из цифр
Первое: Qwen на одном Spark выдаёт ~70–80 ток/с, DeepSeek на двух — ~99–109 ток/с. Если нормировать на железо, картина меняется: Qwen — 70–80 ток/с на Spark, DeepSeek — 49–55 ток/с на Spark. То есть на двух Spark DeepSeek выдаёт в 1,36–1,5 раза больше TPS, чем Qwen на одном, но не удвоение. Зато DeepSeek субъективно умнее — об этом ниже.
Второе: prefill. Qwen разбирает контекст со скоростью 2,3–2,5 тыс. ток/с, DeepSeek — 1,7–2,3 тыс. ток/с. Поэтому на 128K TTFT у Qwen 57 с, у DeepSeek 73 с, хотя TPS у DeepSeek выше. Для холодного разбора длинного промпта это важнее, чем скорость генерации.
Что это значит на практике: это цифры про холодный разбор полного промпта. По p50: на 32K — 13–21 с, на 64K — 27–36 с, на 128K — 57–73 с. Но в кодинг-агенте контекст растёт постепенно: каждый следующий запрос добавляет несколько токенов, а префикс уже лежит в кэше, поэтому TTFT в обычном цикле может быть сильно ниже этих значений. На больших контекстах кэш как раз и спасает.
Планирование
При планировании использую reasoning xhigh у Qwen и high у DeepSeek, а при имплементации — medium у обеих.
Для крупных задач у меня пока такой метод: даю одну и ту же задачу Qwen и DeepSeek и прошу каждую написать план. Отвечаю на уточняющие вопросы каждой модели, получаю два файла с планами в Markdown. Перечитываю планы и уточняю у «автора» непонятные места. При необходимости вношу правки вручную. Затем прошу каждую модель ознакомиться с планом «коллеги» и определить, какой план полнее, какой взять за основу и что из второго в него добавить. На удивление, в моих задачах модели сходились во мнении: DeepSeek утверждал, что его план полнее, и этот план брали за основу; Qwen тоже признавал, что план DeepSeek лучше, и предлагал взять его за основу. Так было в большинстве случаев — только один раз обе модели выбрали план Qwen.
Затем ещё раз вычитываю итоговый план и перехожу к имплементации.
Имплементация
Простой вариант: поручаю реализацию итогового плана одной DeepSeek. Запускаю модель с уровнем reasoning medium и прошу использовать субагентов для разведки и имплементации каждого шага, а также делать отдельный коммит на каждый шаг. Когда появляется первый коммит, начинаю ревьюить его и записывать замечания в Notepad. Таким образом, к моменту завершения задачи у меня уже есть понимание, что именно написано и что в этом коде мне не нравится.
По завершении имплементации передаю список замечаний и прошу их пофиксить. Затем в свежем контексте запускаю ревью силами DeepSeek. Смотрю, какие замечания справедливы, и прошу пофиксить. Затем — ревью и фиксы с помощью Qwen.
Сложный вариант: использую два отдельных worktree и запускаю имплементацию на обеих моделях параллельно. Потом сравниваю оба решения и выбираю более удачное. Затем — два раунда ревью и фиксов.
Тестирование
Сначала, опираясь на итоговый план и код в ветке, прошу обе модели написать план e2e-тестирования на dev-стенде. Потом «скрещиваю» планы и получаю итоговый.
Затем по очереди прошу каждую модель протестировать функционал по плану и пофиксить найденные баги. Как правило, начинаю с DeepSeek; после его фиксов Qwen серьёзных проблем уже не находит, но мелкие недочёты — часто.
Затем — обязательное ручное e2e-тестирование, деплой на стейдж, тестирование на стейдже и, наконец, релиз.
Итоги первой недели
По предварительным оценкам, за первую неделю цикл разработки стал занимать в 3–4 раза больше времени, чем с Claude Code. Иногда кажется, что писать самому было бы быстрее. Но, думаю, это из-за непривычки и дублирования работы на двух моделях. Скорее всего, в будущем остановлюсь на одной модели. По субъективным ощущениям, DeepSeek процентов на 20 умнее и внимательнее, чем Qwen, но для DeepSeek нужен кластер из двух DGX Spark. Если у вас один Spark — Qwen; если два — DeepSeek.
Плюсы
Минусы
Приватность и офлайн: код не уходит в облако
Цикл разработки в 3–4 раза дольше
Нет лимитов, блокировок и верификации
Требуется дорогое железо
Не кодом единым…
На выходных дал DeepSeek задачу настроить запуск Hogwarts Legacy в VR. На этот раз я использовал DeepSeek Harness с уровнем reasoning medium. DeepSeek разведал систему, выяснил, что нужен универсальный инжектор, установил его, скачал профили настроек, написал скрипт для запуска игры в VR и составил подробную инструкцию. На всё ушло около часа.
С первого раза VR не запустился: были проблемы с VR-инжектором. Описал проблему и попросил DeepSeek её диагностировать. Примерно через полчаса DeepSeek разобрался с проблемой, сам запустил игру и инжектор — в этот раз всё взлетело.
Уверен, что Claude Opus 5.5 справился бы с задачей в разы быстрее, но приходится пользоваться тем, что есть. Да, китайским моделям ещё далеко до Opus 5.5, но их уровня уже вполне достаточно для многих задач.
Что дальше
На следующей неделе планирую испытать GLM 5.3 Flash в задачах на кластере из двух Spark. Об этом обязательно напишу.
Ссылки
-
Прошлая статья
-
Рецепт Qwen 3.8 Flash Next (TensorFold)
-
Рецепт DeepSeek-V4.1-Flash-1017 на двух Spark
Источник: habr.com