
Один из основных вопросов на рынке ИТ в 2026 году звучит так: если джун с ИИ закрывает задачи почти так же быстро, как сеньор, а аналитик без опыта получает от модели готовый SQL и аккуратный дашборд, то зачем платить за опыт? У такого вопроса есть весьма аргументированное основание. В исследовании 5 172 сотрудников поддержки ИИ-ассистент поднял производительность в среднем на 15%, причём менее опытные выиграли и в скорости, и в качестве, а самые опытные — немного в скорости при небольшом падении качества. В эксперименте с 453 специалистами, писавшими профессиональные тексты, время выполнения сократилось на 40%, качество выросло на 18%, а неравенство между работниками уменьшилось. Проще говоря, на типовых задачах LLM подтягивает слабых к сильным.
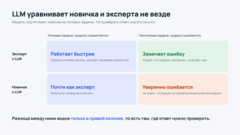 Новичок с LLM vs. эксперт
Но что, если вывод «LLM уравняла новичка и эксперта» — не свойство модели, а свойство того, как мы их сравниваем? Например, что если сам процесс найма в ИТ стал таким, что вооруженный LLM вкатун с нулевым опытом легко может обойти сеньора в борьбе за вакантное место?
Что такое экспертиза
Получается, что LLM уравнивает новичка и опытного не вообще, а в определённой области: на типовых задачах в пределах возможностей модели и там, где результат не требует проверки от человека. За этой областью разрыв сохраняется, а иногда и растёт. Почему? Ответ дала когнитивная психология задолго до LLM. Экспертиза — это прежде всего содержимое долговременной памяти. Эксперт отличается от новичка не более ёмкой рабочей памятью, а тем, что он уже много раз встречал похожие задачи и хранит готовые схемы их решения. Новичку приходится собирать решение в ограниченной рабочей памяти шаг за шагом. Накопленное знание — главный, а возможно, единственный изменяемый источник различий между людьми.
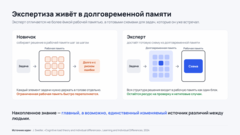 Роль экспертизы в решении задач
Снаружи схемы проявляются в трёх признаках. Во-первых, эксперт узнаёт осмысленные конфигурации: шахматист с одного взгляда запоминает позицию из реальной партии, но не случайную расстановку фигур, и тот же эффект получен на программистах. Во-вторых, эксперт классифицирует задачи по глубинной структуре, а новичок — по внешним признакам: физики-эксперты группировали задачи по закону, который нужен для решения, а студенты — по тому, что изображено в условии. В-третьих, эксперт сразу видит первый шаг решения. Метод, построенный на этом признаке, коррелировал с полным тестом знаний до 0,92 и сокращал время проверки в 2,5–4,9 раза.
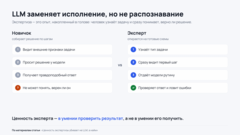 Разница в подходах новичок с LLM vs. эксперт
Теперь видно, почему LLM не заменяет экспертизу. Все три признака — это способность узнать, что перед тобой, и понять, правильно ли оно устроено. Именно это и нужно, чтобы проверить ответ модели и заметить, что задача вышла за пределы её возможностей. Модель порождает текст и код, но схемы для их оценки остаются в голове человека — или отсутствуют. Иными словами, LLM заменяет исполнение, а экспертиза — это прежде всего распознавание.
Найм как уравнитель
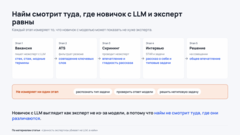
Оттолкнемся от типового процесс найма:
-
описание вакансии составляется с помощью LLM, часто тем, кто не знает предметной области;
-
резюме адаптированы под системы автоматического отбора (ATS), и ATS отсеивает их по совпадению ключевых слов;
-
скрининг проводит неэксперт: что ищете, почему уходите, рассказ о компании;
-
затем идут общие интервью в формате STAR
-
а потом технические интервью, проверяющие только один небольшой кусок экспертизы соискателя
Теперь давайте пройдем по всем этапам и разберем, что именно на них оценивается.
Вакансия и ATS. Схемы, которые нужны роли, определяются классом задач, с которыми человек будет сталкиваться. Если вакансию пишет тот, кто этих задач не знает, он описывает роль через поверхностные признаки: стек, годы опыта, модные термины. Это та же категоризация новичка по внешним признакам, только на стороне работодателя. ATS затем сравнивает ключевые слова резюме с ключевыми словами вакансии — поверхность с поверхностью. Резюме, подогнанное под ключевые слова, одинаково напишет и эксперт, и новичок.
Скрининг. Неэксперт не может отличить глубинный ответ от поверхностного и не узнаёт об этом. В экспериментах с неструктурированными интервью участники формировали уверенное впечатление о собеседнике, даже когда тот отвечал случайным образом, а само интервью ухудшало прогноз по сравнению с одними объективными данными. Субъективная уверенность вообще плохо говорит о точности: надёжная интуиция возникает только в регулярной среде с многократной обратной связью. На этом этапе гладкость рассказа решает больше, чем схемы.
Интервью. Формат STAR (вопросы о прошлом поведении) сам по себе не слабый: со шкалами, где описаны уровни ответов, его валидность в метаанализе достигала 0,63. Но кандидат сам выбирает, о чём рассказать, поэтому без таких шкал интервью во многом измеряет умение рассказывать.
Технические задачи. Алгосы, system design и live coding добавляют другой шум: результат смешан с тревогой от того, что за тобой наблюдают. А еще такие задачи по своей природе типовые, то есть с высокой вероятностью лежат в пределах возможностей модели. Поэтому при использовании LLM на собесе (не важно, легально или нет) результат новичка и сеньора будет в лучшем случае одинаковым.
Получается неприятная петля. Каждый этап измеряет либо поверхностные признаки, либо впечатление, либо результат на типовой задаче. Это ровно та область, где новичок с LLM и опытный специалист похожи. Распознавание, проверку, работу за пределами возможностей модели не измеряет ни один этап. Значит, на выходе найма новичок с LLM и эксперт выглядят одинаково не потому, что модель их уравняла, а потому, что найм смотрит только туда, где они равны.
Здесь нужна честная оговорка. Если роль действительно состоит почти только из типовых задач в пределах возможностей модели, обесценивание опыта в ней реально, и найм тут ни при чём. Но почему-то даже для написания CRUD и покраски кнопок на рынке всегда хотели взять прирожденного инженера.
 Типовой процесс найма в ИТ
Цена уравнивания
Если найм не различает новичка с LLM и эксперта, решение выглядит рациональным: брать того, кто дешевле. Последствия у этого решения двух видов.
Первое — прямые ошибки. Новичок, нанятый на роль, где нужна проверка, будет ошибаться там, где граница возможностей модели пройдена, и не узнает об этом. Это следует из данных о задачах за пределами возможностей модели и об иллюзии компетентности, хотя прямых измерений ошибок найма такого рода нет.
Второе — сломанный конвейер. Эксперты получаются только из новичков. Ещё в 1983 году Лизанна Бейнбридж описала «иронию автоматизации» в промышленности: автоматика забирает у оператора ту самую практику, на которой вырастает навык, нужный, чтобы её контролировать и подменять, когда она ошибается. Перенос на LLM — аналогия, но прямая. Новичок, нанятый как оператор модели, свои схемы не строит.
Экономисты описывают автоматизацию не как замену должностей, а как перераспределение задач: технология вытесняет труд из одних задач и создаёт новые, где он снова нужен. Если найм оценивает людей только по задачам, которые модель уже забрала, он систематически недооценивает тех, кто способен делать оставшиеся.
Круг замыкается: найм не видит экспертизу, рынок за неё не платит, новички растут операторами, и экспертизы действительно становится меньше.
Адаптации найма
Хорошая новость в том, что у психологии отбора персонала есть проверенные инструменты, а теория экспертизы подсказывает, как их нацелить. Ниже — адаптации, разделённые по силе доказательной базы.
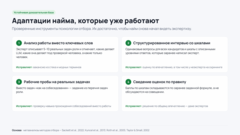
Адаптации с устойчивой доказательной базой.
Анализ работы вместо списка ключевых слов. Вакансия пишется из перечня задач роли, который составляет эксперт: 5–10 типичных задач с отметкой, где каждая находится относительно модели — делает LLM; делает LLM, проверяет человек; задача за пределами возможностей модели.
Структурированное интервью со шкалами. Структурированное интервью называют лучшим методом, потому что из всех методов отбора оно точнее всего предсказывает, как человек будет работать.
За счёт чего:
-
Одинаковые вопросы для всех. Ответы кандидатов можно сравнивать между собой, а не с настроением интервьюера.
-
Вопросы строятся из анализа работы. Спрашивают о том, что действительно понадобится в роли
-
Шкалы с описанными уровнями ответов. Оценщики расходятся меньше относительно оценки кандидата.
-
Меньше места для впечатления. В неструктурированном интервью люди уверенно «понимают» даже случайные ответы, и прогноз от этого ухудшается. Структура отсекает этот эффект.
Рабочие пробы на реальных задачах. Рабочая проба (work sample) — это задание, которое воспроизводит часть реальной работы: кандидат делает работу, а не рассказывает о ней. Связь с последующей эффективностью у неё умеренная, но устойчивая. Пробу можно собрать из перечня задач роли.
Почему метод работает:
-
Измеряется поведение на задаче из самой работы, а не самоописание или впечатление.
-
Если говорить языком теории экспертизы, проба напрямую затрагивает схемы предметной области, а не умение о них рассказать.
Но у этого метода есть и оговорки:
-
Проба частично пересекается с общими способностями. Её корреляция с тестами общих когнитивных способностей составляет 0,32. То есть проба измеряет не только экспертизу.
-
Проба видит только те схемы, которые попали в задание. Узкая проба даёт узкий срез, поэтому её стоит собирать из перечня реальных задач роли.
-
Домашнюю пробу кандидат может сделать с LLM (привет всем любителям типовых тестовых заданий в пределах компетенции LLM). Тогда она перестаёт различать новичка с моделью и эксперта.
 Адаптации с устойчивой доказательной базой
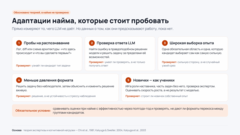
Адаптации, обоснованные теорией, но не проверенные в найме.
Пробы на распознавание. Короткие задания «первого шага»: фрагмент лога, diff, схема архитектуры с вопросом «что здесь происходит и что вы сделаете первым?», с ключом ответов от эксперта. Или сортировка 6–8 коротких описаний проблем с объяснением, как в исследованиях классификации задач экспертами. Метод хорошо работает в обучении; в ИТ-найме он не валидирован.
Пробы на проверку ответа LLM. Внутри рабочей пробы: найти ошибку в правдоподобном решении, сгенерированном моделью, и решить задачу за пределами её возможностей. Это прямое измерение того, что отличает эксперта от новичка с моделью, но данных о валидности таких проб пока нет.
Широкая выборка схем. Одна обязательная область и одна, которую кандидат выбирает сам как самую сильную. Это снижает риск, что интервью увидит узкий и не самый сильный срез. Объяснение или изменение решения вживую проверяет, что обработку делал сам кандидат.
Меньше внешней нагрузки от формата. Если результат live coding смешан с тревогой от наблюдения, формат стоит менять, например давать решить задачу без наблюдателя и затем обсуждать.
Цену этих адаптаций стоит оговорить сразу. Они требуют времени экспертов на каждом этапе — от перечня задач до шкал и оценки проб. Но альтернатива — найм, который экспертизу не видит, — в итоге обходится дороже.
 Адаптации, обоснованные теорией, но не проверенные в найме
Заключение
Схема, которую мы собрали, читается так. LLM действительно сокращает разрыв между новичком и опытным, но только на типовых задачах в пределах своих возможностей и только в порождении результата. Экспертиза же — это схемы распознавания, которые нужны, чтобы проверить ответ и заметить выход за границу возможностей модели. Типовой найм измеряет поверхностные признаки, впечатление и результат на типовых задачах — ровно то, в чём новичок с LLM и эксперт похожи. Поэтому их уравнивает не модель, а найм.
 Найм для оценки экспертизы
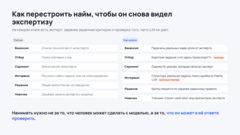
Отсюда три вывода. Первый: тезис «LLM обесценила опыт» в значительной мере — артефакт измерения, а не свойство технологии. Второй: у психологии отбора есть инструменты с устойчивой доказательной базой — анализ работы, структурированное интервью со шкалами, рабочие пробы, механическое сведение оценок, — и их достаточно, чтобы найм снова начал видеть экспертизу. Третий: пробы на распознавание и проверку ответа LLM — самый прямой способ измерить то, чего модель не даёт, но их ещё нужно валидировать.
Для компаний вывод практический: пока найм уравнивает новичка с моделью и эксперта, экономия на опыте сегодня превращается в нехватку проверяющих завтра. Для специалистов вывод не менее конкретный: ценность растёт там, где человек умеет распознать и проверить, а не там, где он быстрее всех получает ответ.
Статья написана при участии Claude Code (Anthropic). Автор отобрал исследования, изучил их, сформулировал главную мысль статьи, а также написал черновик материала. Claude Code проверил ошибки, отредактировал текст, а также подготовил инфографику.
Что почитать
Экспертиза и схемы
-
Chase W. G., Simon H. A. Perception in chess // Cognitive Psychology. 1973. Vol. 4, No. 1. P. 55–81 — классическое исследование узнавания позиций: эксперт запоминает осмысленные, но не случайные конфигурации.
-
Chi M. T. H., Feltovich P. J., Glaser R. Categorization and Representation of Physics Problems by Experts and Novices // Cognitive Science. 1981. Vol. 5, No. 2. P. 121–152 — эксперты классифицируют задачи по принципам решения, новички — по внешним признакам.
-
McKeithen K. B., Reitman J. S., Rueter H. H., Hirtle S. C. Knowledge organization and skill differences in computer programmers // Cognitive Psychology. 1981. Vol. 13, No. 3. P. 307–325 — эффект узнавания и организации знаний, воспроизведённый на программистах.
-
Sweller J. Cognitive load theory and individual differences // Learning and Individual Differences. 2024. Vol. 110. Article 102423 — экспертиза как содержимое долговременной памяти и главный изменяемый источник различий.
-
Kalyuga S., Sweller J. Measuring Knowledge to Optimize Cognitive Load Factors During Instruction // Journal of Educational Psychology. 2004. Vol. 96, No. 3. P. 558–568 — метод «первого шага»: корреляция с полным тестом до 0,92 при сокращении времени в 2,5–4,9 раза.
-
Kalyuga S., Ayres P., Chandler P., Sweller J. The Expertise Reversal Effect // Educational Psychologist. 2003. Vol. 38, No. 1. P. 23–31 — почему поддержка, полезная новичку, мешает опытному.
ИИ, производительность и проверка
-
Brynjolfsson E., Li D., Raymond L. Generative AI at Work // The Quarterly Journal of Economics. 2025. Vol. 140, No. 2. P. 889–942 — 5 172 сотрудника поддержки: +15% в среднем, наибольший выигрыш у менее опытных.
-
Noy S., Zhang W. Experimental evidence on the productivity effects of generative artificial intelligence // Science. 2023. Vol. 381, No. 6654. P. 187–192 — 453 специалиста: −40% времени, +18% качества, меньше неравенства между работниками.
-
Dell’Acqua F., McFowland E., Mollick E., et al. Navigating the Jagged Technological Frontier: Field Experimental Evidence of the Effects of Artificial Intelligence on Knowledge Worker Productivity and Quality // Organization Science. 2026. Vol. 37, No. 2. P. 403–423 — 758 консультантов: выигрыш внутри границы возможностей модели и −19% верных решений за её пределами.
-
Prather J., Reeves B. N., Leinonen J., et al. The Widening Gap: The Benefits and Harms of Generative AI for Novice Programmers // Proceedings of ICER 2024. P. 469–486 — как генеративный ИИ ускоряет сильных новичков и создаёт иллюзию компетентности у слабых.
-
Goddard K., Roudsari A., Wyatt J. C. Automation bias: a systematic review of frequency, effect mediators, and mitigators // Journal of the American Medical Informatics Association. 2012. Vol. 19, No. 1. P. 121–127 — от чего зависит чрезмерное доверие автоматике и что его снижает.
-
Lee H.-P., Sarkar A., Tankelevitch L., et al. The Impact of Generative AI on Critical Thinking: Self-Reported Reductions in Cognitive Effort and Confidence Effects From a Survey of Knowledge Workers // Proceedings of CHI 2025. P. 1–22 — доверие к ИИ связано с меньшим критическим мышлением.
Валидность методов отбора
-
Sackett P. R., Zhang C., Berry C. M., Lievens F. Revisiting meta-analytic estimates of validity in personnel selection: Addressing systematic overcorrection for restriction of range // Journal of Applied Psychology. 2022. Vol. 107, No. 11. P. 2040–2068 — пересмотр валидности: структурированное интервью на первом месте, оценки ниже прежних на 0,10–0,20.
-
Roth P. L., Bobko P., McFarland L. A. A meta-analysis of work sample test validity: Updating and integrating some classic literature // Personnel Psychology. 2005. Vol. 58, No. 4. P. 1009–1037 — валидность рабочих проб: 0,26 без поправок и 0,33 с поправкой.
-
Kuncel N. R., Klieger D. M., Connelly B. S., Ones D. S. Mechanical versus clinical data combination in selection and admissions decisions: A meta-analysis // Journal of Applied Psychology. 2013. Vol. 98, No. 6. P. 1060–1072 — механическое сведение оценок предсказывает лучше целостного суждения, даже экспертного.
Интервью и суждение интервьюера
-
Levashina J., Hartwell C. J., Morgeson F. P., Campion M. A. The Structured Employment Interview: Narrative and Quantitative Review of the Research Literature // Personnel Psychology. 2014. Vol. 67, No. 1. P. 241–293 — обзор того, из чего складывается структура интервью и что известно о каждом её элементе.
-
Taylor P. J., Small B. Asking applicants what they would do versus what they did do: A meta-analytic comparison of situational and past behaviour employment interview questions // Journal of Occupational and Organizational Psychology. 2002. Vol. 75, No. 3. P. 277–294 — валидность вопросов о прошлом поведении (0,63) и согласованность оценщиков со шкалами (0,77–0,79).
-
Dana J., Dawes R., Peterson N. Belief in the unstructured interview: The persistence of an illusion // Judgment and Decision Making. 2013. Vol. 8, No. 5. P. 512–520 — уверенные впечатления от случайных ответов и ухудшение прогноза после неструктурированного интервью.
-
Kahneman D., Klein G. Conditions for intuitive expertise: A failure to disagree // American Psychologist. 2009. Vol. 64, No. 6. P. 515–526 — когда интуиции можно доверять и почему субъективная уверенность не говорит о точности.
-
Behroozi M., Shirolkar S., Barik T., Parnin C. Does stress impact technical interview performance? // Proceedings of ESEC/FSE 2020. P. 481–492 — результат технического интервью у доски смешан с тревогой от наблюдения.
Автоматизация, научение и труд
-
Bastani H., Bastani O., Sungu A., et al. Generative AI without guardrails can harm learning: Evidence from high school mathematics // Proceedings of the National Academy of Sciences. 2025. Vol. 122, No. 26. Article e2422633122 — +48% и +127% с доступом, −17% после отключения, роль защитных подсказок.
-
Bainbridge L. Ironies of automation // Automatica. 1983. Vol. 19, No. 6. P. 775–779 — автоматизация лишает оператора практики, которая нужна, чтобы её контролировать.
-
Acemoglu D., Restrepo P. Automation and New Tasks: How Technology Displaces and Reinstates Labor // Journal of Economic Perspectives. 2019. Vol. 33, No. 2. P. 3–30 — автоматизация как перераспределение задач: вытеснение и восстановление труда.
Источник: habr.com