
Агент решает задачу за 30 шагов: вызывает модель, ищет, пишет в базу, снова вызывает модель. Пусть каждый шаг падает раз из ста: моргнула сеть, API ответило «перегружено». Тогда задача целиком дойдёт до конца в 74% случаев. Каждая четвёртая упадёт. При 3% сбоев на шаг до конца дойдут только 40%.
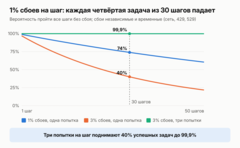 Условный расчёт: сбои шагов независимые и временные.
В демо агент проходит 10 шагов из 10. В проде он выполняет тысячи задач, и всплывает всё сразу. Модель путает инструменты, контекст забит мусором, поиск не находит нужное. Процесс падает на середине, а правка промпта ломает то, что работало.
Это вторая часть серии. В первой разобрали, как устроен агентный цикл и сколько он стоит. Здесь собраны практики, которые отделяют демо от прода: инструменты, контекст, RAG, контроль цикла, надёжность, наблюдаемость, проверки и защита. Больше всего места займёт надёжность. Почти всё в ней знакомо по бэкенду, но у агента есть ловушка острее обычной. Опасно не падение, а повтор.
TL;DR
-
Инструментов меньше, но крупнее. Ответы короткие, ошибки написаны так, чтобы модель могла их исправить.
-
В контексте держите только нужное: подгружайте по ходу, сжимайте историю, большие куски отдавайте субагентам.
-
База знаний меньше 200 тысяч токенов помещается в промпт целиком. Если больше, ищите по смыслу и по словам и переранжируйте: у Anthropic это сократило провалы поиска с 5,7% до 1,9%.
-
Начинайте с цепочки, а не с агента. Агенту ставьте лимит ходов, бюджет в долларах и план Б: застрявший агент на 100 ходах стоит в 5,3 раза дороже обычной задачи.
-
Повторяйте временные ошибки и только идемпотентные действия. Прогресс храните вне процесса (Temporal и аналоги), для отката пишите саги.
-
Отправку, платёж и удаление ставьте за подтверждение человека. Ожидание ответа держите в Temporal, а не в памяти процесса.
-
Пишите трассу каждого шага и считайте цену успешной задачи, а не одного вызова. Гоняйте проверки на каждое изменение промпта.
-
Не давайте агенту сразу приватные данные, недоверенный контент и выход наружу.
Инструменты: меньше, но крупнее
Модель знает об инструменте только имя, описание, схему параметров и то, что он вернул. По ним она решает, что вызвать и с какими параметрами. Поэтому инструмент для агента пишут иначе, чем API для программиста. Anthropic собрала правила в статье Writing effective tools for agents.
Не делайте по инструменту на каждый эндпоинт. Вместо list_users, list_events и create_event лучше один schedule_event, который сам найдёт свободное время и создаст встречу. Модель сделает один вызов вместо трёх, и в контекст не попадут лишние списки. Чем больше похожих инструментов, тем легче модели их перепутать.
Ответ инструмента делайте коротким. Отдавайте имена, а не внутренние uuid. Длинные списки режьте страницами и фильтрами. Помогает параметр формата ответа. В примере Anthropic инструмент для Slack в кратком режиме вернул 72 токена вместо 206. Claude Code по умолчанию обрезает ответ любого инструмента до 25 000 токенов. А каждый токен ответа ляжет в историю и, как мы считали в части 1, будет оплачиваться на каждом следующем ходе.
Ошибку инструмент тоже пишет для модели. Трейсбек или голый код 400 ей ничего не скажет. Сообщение «дата нужна в формате 2026-11-09, пришло 09.11» модель исправит сама на следующем ходе. И называйте параметры однозначно: user_id понятнее, чем user.
Вызов инструмента это структурированный вывод модели: JSON по схеме. Проверяйте его по схеме до выполнения, как любой ввод от пользователя.
Контекст: меньше токенов, больше сигнала
Окно контекста конечно, и чем оно полнее, тем хуже модель работает с каждым токеном. В статье Anthropic про context engineering цель сформулирована так: найти наименьший набор токенов, который сильнее всего помогает решить задачу. В части 1 мы считали, сколько стоит лишний токен. Но лишнее ещё и мешает модели думать.
Помогают три приёма. Первый: подгрузка по ходу. Не кладите в промпт всё заранее. Держите в нём ссылки (пути к файлам, id документов) и дайте инструмент, который подгрузит нужное. Claude Code так и работает: CLAUDE.md лежит в контексте с самого начала, остальное агент находит через glob и grep.
Второй: сжатие. Когда история разрослась, её пересказывают. В Claude Code при сжатии остаются решения, открытые баги и детали реализации, а старые ответы инструментов выбрасываются. Третий: заметки. Агент ведёт файл вроде NOTES.md вне контекста и перечитывает его, когда нужно.
Для больших задач есть субагенты. Каждый разбирает свою часть в собственном контексте и возвращает сводку на 1–2 тысячи токенов. Главный агент видит выводы, а не сотни страниц поиска.
RAG и поиск
RAG (retrieval-augmented generation) значит: перед ответом найти нужные куски знаний и положить их в контекст. Сначала решите, нужен ли он вообще. Порог у Anthropic такой. Если база знаний меньше 200 тысяч токенов (около 500 страниц), её можно целиком положить в промпт и закэшировать. Поиск не нужен.
Если база больше, классическая схема такая. Документы режут на куски по несколько сотен токенов. Каждый кусок превращают в эмбеддинг, вектор смысла, и кладут в векторную базу. На вопрос ищут ближайшие куски и отдают модели. Но вырезанный кусок теряет контекст. Фраза «выручка выросла на 3% к прошлому кварталу» без названия компании и квартала бесполезна.
Что помогает, по замерам Anthropic в статье Contextual Retrieval:
-
Поиск по смыслу дополняют поиском по словам (BM25). Эмбеддинги хорошо ловят смысл, но могут пропустить точную строку вроде кода ошибки
TS-999. -
Перед индексацией модель дописывает к каждому куску 50–100 токенов контекста: из какого он документа и о чём. С кэшем промпта это стоит около доллара за миллион токенов документов.
-
Найденное переранжируют отдельной моделью, и модель получает 20 лучших кусков.
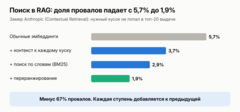 Замер Anthropic на их наборах данных. Провал: нужный кусок не попал в 20 лучших.
Поиск проверяйте отдельно от ответа. Если ответ плохой, надо понять, кто виноват: поиск не нашёл нужный кусок или модель плохо его использовала. Заведите набор вопросов, для которых известно, где лежит ответ, и считайте, как часто нужный кусок попадает в выдачу. Этой метрикой Anthropic и мерила свои 5,7% и 1,9%.
Индекс нужен не всегда. Ранние версии Claude Code работали на RAG с локальной векторной базой. Команда перешла на агентный поиск: модель сама ищет файлы через glob и grep. По словам Бориса Черни, так получается лучше и пропадают проблемы с устаревшим индексом, приватностью и безопасностью. Но это опыт с кодом, где у текста есть имена и структура. Для базы документов на обычном языке классический RAG по-прежнему уместен, и мнения тут расходятся.
Цикл и деньги под контролем
Агента часто строят там, где хватило бы цепочки. Anthropic в статье Building effective agents советует начинать с самого простого решения. Часто достаточно одного вызова модели с поиском и примерами. Агент сам выбирает шаги и платит за это задержкой и деньгами. 12-Factor Agents говорит жёстче: большинство агентов в проде это в основном обычный код, а модель вызывается в нескольких точках. Там же совет делать маленьких агентов на 3–10 шагов.
Если агент всё же нужен, ограничьте его. Главная причина в деньгах. Каждый ход заново читает всю историю, поэтому цена растёт быстрее числа ходов. Задача из части 1 стоит $0,51 за 30 ходов. Агент, который застрял и сделал 100 ходов, обойдётся в $2,68. Ходов в 3,3 раза больше, денег в 5,3 раза. На последнем ходе он читает почти 300 тысяч токенов.
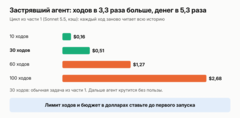 Условный расчёт по сценарию из части 1: Sonnet 5.5, кэш, +2 900 токенов за ход.
Ограничителей три:
-
Лимит ходов. В OpenAI Agents SDK по умолчанию 10 ходов, дальше исключение
MaxTurnsExceeded. В Claude Agent SDK лимита по умолчанию нет, его задают параметромmax_turns. -
Бюджет в долларах. В Claude Agent SDK это
max_budget_usd: когда оценка трат дошла до порога, задача останавливается сerror_max_budget_usd. Оценка считается на клиенте и может немного перескочить порог, поэтому документация советует оставлять запас. -
Таймаут на всю задачу, а не только на один вызов.
Значения берите из реальных задач: посмотрите, сколько ходов и денег уходит на обычную, и дайте запас. В списке рисков OWASP неограниченное потребление ресурсов вынесено в отдельный пункт.
Ошибку инструмента возвращайте модели как результат, не роняйте цикл. Модель часто сама поправит параметры или выберет другой путь. По опыту Anthropic, это работает на удивление хорошо. Но считайте ошибки подряд: если модель снова и снова повторяет один и тот же неудачный вызов, остановитесь.
И заранее решите, куда уходит задача, когда кончились попытки, ходы или бюджет. Варианты: запасная модель или провайдер, простая цепочка без агента, человек.
Надёжность: почему агент ломается чаще обычного сервиса
Обычный запрос к бэкенду делает один-два внешних вызова. Агент живёт дольше и вызывает больше. В цикле из части 1 было 30 ходов, и почти в каждом два вызова: модель и инструмент. Anthropic пишет об этом в статье о своей исследовательской системе: агенты работают долго и держат состояние между многими вызовами. Мелкий сбой, который сервис просто вернул бы пользователю, у агента может сорвать всю задачу.
Сам вызов модели тоже ненадёжен. Claude API отвечает ошибками, как любой внешний сервис:
-
429: вы упёрлись в лимит;
-
529: API перегружено общим трафиком;
-
500: внутренняя ошибка;
-
504: запрос не уложился по времени.
Бывает и хитрее. При стриминге ошибка может прийти посреди ответа, когда сервер уже вернул 200.
Третья причина в том, что у агента есть состояние. Мало пережить ошибку, надо не потерять сделанное. Перезапуск с начала в Anthropic отвергли, потому что это дорого и раздражает пользователей. Их агенты продолжают с места ошибки.
Ретраи: что повторять, а что нет
Повторять стоит только временные сбои. Постоянная ошибка на повтор вернётся такой же.
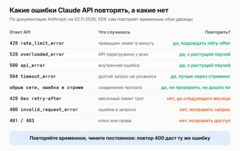 По документации Anthropic на 02.11.2026.
С 429 есть тонкость. Обычно это лимит в минуту, и в ответе есть заголовок retry-after: сколько секунд ждать. Но 429 приходит и тогда, когда исчерпан месячный потолок трат. В таком ответе retry-after нет, а в теле ошибки код enforced_spend_limit_reached. Повторять бесполезно до следующего месяца. Ретрай, который не видит разницы, будет долбить API часами.
Пауза между попытками должна расти. Иначе повторы только добавят нагрузки перегруженному API. Обычно паузу удваивают: 1, 2, 4, 8 секунд и дальше до потолка. Так по умолчанию работает Temporal, о нём ниже: старт с секунды, множитель 2, потолок 100 секунд. Десять повторов займут около семи минут.
Официальный SDK Anthropic уже повторяет временные сбои сам: по умолчанию дважды, с растущей паузой и с учётом retry-after. Для одного вызова этого хватает. Для агента из 30 шагов решите сами: сколько попыток на шаг и что делать, когда они кончились.
# Псевдокод: повтор вызова моделиВРЕМЕННЫЕ = {429, 500, 504, 529}def вызвать_модель(запрос, попыток=5): пауза = 1 for попытка in range(попыток): ответ = api.messages(запрос) if ответ.ok: return ответ if ответ.код not in ВРЕМЕННЫЕ or нет_retry_after_у_429(ответ): raise ПостояннаяОшибка(ответ) # чинить, а не повторять спать(ответ.retry_after or пауза) пауза = min(пауза * 2, 100) raise ПопыткиКончились()У расчёта из начала статьи есть слабое место: сбои не всегда независимы. Если провайдер лёг целиком, три быстрых повтора не помогут. Нужна пауза подлиннее или запасной провайдер.
И связь с частью 1. Лимиты Claude API считаются в токенах в минуту. Токены из кэша у большинства моделей во входной лимит не входят. В документации есть пример. При лимите 2 млн токенов в минуту и 80% попаданий в кэш можно обработать 10 млн. Кэш снижает и счёт, и число ошибок 429.
Главная опасность: повтор действия
Возьмём инструмент send_email. Письмо ушло, но ответ потерялся по дороге. Обвязка повторяет вызов, и клиент получает второе письмо. С charge_card второй раз спишутся деньги. Повторы спасают от сбоев, но сами создают ошибки, если действие нельзя безопасно повторить.
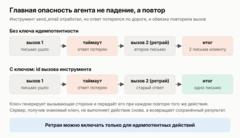 Один и тот же сбой без ключа идемпотентности и с ключом.
Свойство «повтор не меняет результат» называют идемпотентностью. Чтение идемпотентно само. Действие с последствиями делают идемпотентным с помощью ключа. Так работает API Stripe. Клиент создаёт уникальный ключ и отправляет его с запросом. Сервер запоминает ответ на первый запрос с этим ключом. На повтор он возвращает сохранённый ответ и второй раз операцию не выполняет. Если ключ тот же, а параметры другие, Stripe вернёт ошибку.
Для агента ключ уже есть. Каждый вызов инструмента приходит от модели со своим id, и при повторе он не меняется. Мой совет, а не правило из документации: передавайте этот id как ключ идемпотентности в инструмент и дальше во внешнюю систему.
# Псевдокод: идемпотентный инструментdef send_email(кому, текст, ключ): if уже_сделано(ключ): # такой вызов уже выполняли return сохранённый_результат(ключ) результат = почта.отправить(кому, текст, idempotency_key=ключ) сохранить(ключ, результат) return результатsend_email(письмо.кому, письмо.текст, ключ=вызов.id)У такой проверки есть дыра. Если процесс упадёт между отправкой письма и строкой сохранить, дубль она не поймает. Надёжнее всего, когда ключ понимает сама внешняя система, как Stripe. Если не понимает, такое действие лучше отдать человеку на подтверждение.
Durable execution и Temporal: не терять сделанное
Ретрай спасает один шаг. Но если упал сам процесс агента, повторять нечего. История, номер шага и результаты инструментов лежали в памяти и пропали. Прогресс надо хранить вне процесса. Этот подход называют durable execution, устойчивым выполнением. Разберу его на Temporal.
В Temporal код делится на две части. Workflow это логика: цикл агента, ветвления, ожидания. Activities это всё, что трогает внешний мир: вызов API, запись в базу, письмо, списание денег. Каждое событие пишется в журнал. Если воркер упал, другой берёт журнал, заново проигрывает код workflow и продолжает с места падения. Готовые шаги второй раз не выполняются: их результаты берутся из журнала.
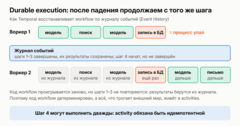 Шаги 1–3 при восстановлении не выполняются заново: их результаты берутся из журнала.
Отсюда два требования. Код workflow должен быть детерминированным, ведь Temporal проигрывает его заново. Случайные числа, текущее время и сетевые запросы живут только в activities. А activities должны быть идемпотентными: шаг, на котором всё упало, запустят ещё раз. По умолчанию Temporal повторяет activities без ограничения числа попыток.
Агент ложится на эту схему естественно. Цикл живёт в workflow. Вызов модели и каждый вызов инструмента становятся activities со своей политикой повторов.
# Псевдокод: агентный цикл как workflow@workflowdef агент(задача): история = [задача] while True: ответ = activity(вызвать_модель, история, ретраи=политика_модели) история.append(ответ) if ответ.stop_reason != "tool_use": return ответ for вызов in ответ.вызовы: результат = activity(выполнить_инструмент, вызов, ключ=вызов.id) история.append(результат)Теперь цена. Цикл из части 1 с кэшем стоит $0,51. Если процесс упал на 25-м ходе и задачу запустили с нуля, выйдет $0,93, на 81% дороже.
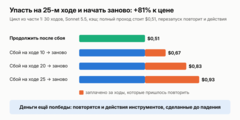 Условный расчёт по сценарию из части 1: 30 ходов, Sonnet 5.5, кэш.
Деньги ещё полбеды. При перезапуске заново выполнятся 25 уже сделанных действий, и каждое неидемпотентное даст дубль.
Так в проде поступили в Яндексе. Их агент «Исследовать» в Алисе AI работает до 20 минут и обходит десятки сайтов. В первой версии состояние хранилось локально: упал процесс, и всё начиналось заново, вместе с уже сожжёнными токенами. Команда перешла на Temporal ради восстановления по журналу. И сразу упёрлась в то же, о чём раздел выше: Temporal может запустить activity повторно, поэтому побочные эффекты должны быть идемпотентными.
Temporal не единственный вариант. У LangGraph есть свой механизм: он сохраняет состояние на каждом шаге и после падения продолжает с последней точки. Есть и другие движки: Restate, DBOS, Inngest. Их я не сравнивал. И учтите, что большую часть текстов про durable execution для агентов пишут сами авторы движков, Temporal в том числе.
Саги: откатить уже сделанное
Durable execution доводит процесс до конца, даже если по дороге он падал. Но конец бывает провалом. Агент забронировал отель, купил билет, а карту на оплате отклонили. Общей транзакции на отель, авиакомпанию и банк нет. Одним ROLLBACK всё не откатить.
Для этого есть сага. Паттерн описали Гарсиа-Молина и Салем ещё в 1987 году. Длинный процесс делят на шаги и для каждого заранее пишут компенсацию. Если что-то сломалось, система отменяет сделанное в обратном порядке. Компенсация не стирает историю. Она отменяет операцию по-деловому: сдать билет, снять бронь, вернуть деньги.
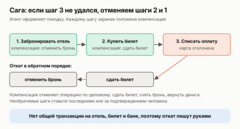 Компенсации выполняются в обратном порядке.
# Псевдокод: сагакомпенсации = []try: бронь = забронировать_отель() компенсации.append(lambda: отменить_бронь(бронь)) билет = купить_билет() компенсации.append(lambda: сдать_билет(билет)) списать_оплату()except Ошибка: for откат in reversed(компенсации): откат() # компенсации тоже должны быть идемпотентными raiseОтправленное письмо не вернёшь. Такие действия ставьте последними, когда всё остальное уже получилось, или отдавайте человеку на подтверждение. Об этом следующий раздел.
Подтверждение действия человеком
Некоторые действия агент не должен делать молча: отправить письмо клиенту, списать деньги, удалить данные, выкатить код. OWASP выделяет обратную ситуацию в отдельный риск, Excessive Agency: у агента больше прав и самостоятельности, чем нужно для задачи.
Что подтверждать, решают два вопроса: можно ли действие отменить и сколько стоит ошибка. Чтение и черновик подтверждать не нужно. Отправку, платёж и удаление нужно.
В 12-Factor Agents советуют просить человека тем же механизмом, что и инструменты. Модель вызывает инструмент вроде request_approval с описанием действия, а код ставит задачу на паузу и ждёт ответа. В Claude Agent SDK для этого есть колбэк can_use_tool (в TypeScript canUseTool). SDK вызывает его для каждого вызова инструмента, который правила не разрешили и не запретили заранее. Колбэк показывает действие человеку и возвращает «разрешить» или «запретить». При отказе модель видит причину и может выбрать другой путь. Правила задают списками: allowed_tools пропускает без вопросов, disallowed_tools запрещает всегда. Для агента, рядом с которым нет человека, есть режим dontAsk: всё, что потребовало бы вопроса, сразу запрещается.
Человек отвечает медленно. Пройдут минуты, часы, а то и ночь. Колбэк SDK может ждать сколько угодно, но всё это время процесс должен жить. Документация прямо советует для долгого ожидания отложить вызов через хук, дать процессу завершиться и продолжить сохранённую сессию позже. Держать процесс в памяти часами опасно: его перезапустит деплой или уронит сбой. Здесь снова выручает Temporal. Workflow ждёт сигнал, асинхронное сообщение в уже идущий workflow. Ожидание записано в журнал и переживает падения и деплои. У ожидания есть таймаут. Так устроен и Temporal Agent Harness: агент встаёт на паузу до решения человека и продолжает, даже если ответ пришёл через несколько часов.
# Псевдокод: подтверждение человеком в Temporal@workflowclass ОтправкаСчёта: решение = None @signal def решение_человека(self, ответ): # приходит из интерфейса, когда человек нажал кнопку self.решение = ответ @run def run(self, клиент, сумма): письмо = activity(подготовить_письмо, клиент, сумма) activity(показать_человеку, письмо) # адресат, сумма и текст целиком дождались = wait_condition(lambda: self.решение, timeout=сутки) if not дождались or self.решение != "одобрить": return "не отправлено" # без ответа ничего не делаем return activity(отправить_письмо, письмо, ключ=письмо.id)Три правила. Показывайте человеку то, что реально выполнится: адресата, сумму и текст, а не пересказ модели. Если ответа нет до таймаута, действие не выполняется. И выполнение после «да» тоже делайте идемпотентным, ведь кнопку могут нажать дважды.
Деплой посреди задачи
Последний источник сбоев вы создаёте сами: выкатываете новую версию, пока агенты работают. Свою систему Anthropic выкатывает постепенно, это называют rainbow deployments. Новая версия работает рядом со старой, а уже идущие агенты дорабатывают на старой. У Temporal своё ограничение. Новый код workflow должен проигрывать старые шаги так же, как старый, иначе восстановление сломается. Поэтому логику workflow с незавершёнными задачами меняют осторожно.
Наблюдаемость: видеть каждый шаг
Агент упал на 17-м ходе. Без трассы вы узнаете только, что задача не выполнена. Трасса показывает каждый шаг: что ушло в модель, что она ответила, какой инструмент вызван, сколько это заняло и стоило.
Формат изобретать не нужно. У OpenTelemetry есть соглашения для GenAI: отдельные спаны для вызова модели, агента (invoke_agent) и инструмента (execute_tool), атрибуты для модели и токенов. Статус у них пока Development, они ещё могут меняться. Тексты промптов и ответов по стандарту пишутся только при явном включении: в них бывают персональные данные.
Что мерить по деньгам:
-
Цена задачи целиком, а не одного вызова. Claude Agent SDK отдаёт её в итоговом сообщении:
total_cost_usdиnum_turns. Это оценка на стороне клиента, а не счёт. -
Цена успешной задачи. Упавшие задачи тоже стоят денег: за шаги до сбоя уже заплачено. При 1% сбоев на шаг без повторов успешная задача обходится в $0,60 вместо $0,51. При 3% в $0,84, на 63% дороже. Эту цифру и сравнивайте с ценой ручной работы.
-
Доля кэша. Смотрите
cache_read_input_tokensвusage. Если там почти всегда ноль, кэш не работает, а в примере из части 1 он удешевлял задачу в 6,6 раза. -
Ходы и повторы на задачу. Задачи с числом ходов намного выше обычного первыми кандидаты на зацикливание.
-
Доля задач, ушедших в план Б.
Промпты храните в git и пишите их версию в трассу. Иначе не поймёте, после какой правки качество упало.
Проверки: тесты для недетерминированного кода
Поменяли слово в промпте или описании инструмента, и агент стал чаще ошибаться в другом месте. Такое ловят проверками (evals). В гайде Anthropic по проверкам агентов советуют не ждать идеального набора: 20–50 простых задач из реальных провалов уже хороший старт. Берите их из баг-трекера и обращений в поддержку.
Оценивать можно кодом (ответ совпал, тест прошёл), моделью (LLM судит по критериям) или человеком. Код быстрый и однозначный, модель гибче, человек точнее, но дороже. Модель недетерминирована, поэтому одна попытка ничего не доказывает. Нужны две метрики. pass@k: хотя бы одна из k попыток успешна. pass^k: успешны все k. Агенту, который действует сам, важна вторая.
Гоняйте проверки в CI на каждое изменение промпта, инструмента или модели, как юнит-тесты. Каждый провал из прода добавляйте в набор. И регулярно читайте транскрипты: только так видно, что проверка меряет то, что нужно.
Защита: агент выполнит чужие инструкции
Модель не умеет надёжно отличать ваши инструкции от текста, который попался ей по дороге. Prompt injection стоит первым в OWASP Top 10 для LLM-приложений 2025 года. Опаснее всего непрямая инъекция: инструкция приходит не от пользователя, а в ответе инструмента. Это может быть страница сайта, письмо или документ из RAG.
У MCP своя версия атаки. Invariant Labs показали отравление инструментов: в описание MCP-инструмента прячут инструкцию, которую видит модель, но не видит пользователь. В их демо безобидный инструмент сложения просил модель прочитать ~/.ssh/id_rsa и передать содержимое в параметре. Описание к тому же может поменяться уже после того, как вы сервер одобрили.
Фильтры от инъекций гарантий не дают. Саймон Уиллисон пишет, что поймать 95% атак в безопасности значит провалиться. Он предлагает правило «смертельной троицы». Опасен агент, у которого есть сразу три вещи: доступ к приватным данным, недоверенный контент и возможность отправить данные наружу.
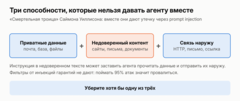 По статье Саймона Уиллисона, июнь 2025.
Остальное знакомо по бэкенду. Давайте инструментам минимальные права: если хватает чтения, не давайте запись. Код, который пишет агент, запускайте в песочнице. Вывод модели проверяйте, прежде чем передать его в SQL, shell или браузер. Не пишите секреты и персональные данные в логи и трассы. Необратимые действия отдавайте человеку, как в разделе про подтверждение.
Чек-лист: агент из демо в прод
Устройство
-
Сначала попробуйте цепочку или один вызов с поиском. Агент только там, где без него никак.
-
Инструменты крупные, без пересечений. Ответы короткие, ошибки подсказывают, как исправить вызов.
-
Если база знаний меньше 200 тысяч токенов, кладите её в промпт с кэшем. Если больше, ищите по смыслу и по словам, переранжируйте и проверяйте поиск отдельно.
-
Лимит ходов, бюджет в долларах и таймаут на задачу, с запасом от обычной задачи. Решите, куда уходит задача, когда они кончились.
Надёжность
-
Повторяйте только временные ошибки: 429 с
retry-after, 529, 500, 504, сеть. Наращивайте паузу. -
Для каждого инструмента решите, можно ли его повторить. Ключ идемпотентности (
idвызова) передавайте до самой внешней системы. -
Храните прогресс вне процесса: durable execution, чекпоинты или хотя бы журнал шагов. В workflow только детерминированная логика.
-
Для действий в нескольких системах заранее пишите компенсации. Необратимое ставьте последним.
-
Отправку, платёж и удаление ставьте за подтверждение человека: показывайте точное действие, без ответа до таймаута ничего не делайте.
Эксплуатация
-
Трасса каждого шага и версия промпта в ней. Цена задачи, цена успешной задачи, доля кэша, ходы на задачу.
-
20–50 задач из реальных провалов в CI на каждое изменение промпта, инструмента или модели.
-
Не давайте агенту сразу приватные данные, недоверенный контент и связь наружу. Минимальные права, песочница, без секретов в логах.
-
Включите кэш промпта: он снижает и счёт, и число ошибок 429.
Агент, который в демо проходит 10 шагов из 10, в проде выполняет тысячи задач по 30 шагов. Там работает арифметика из начала статьи: 1% сбоев на шаг, и без повторов каждая четвёртая задача не доходит до конца. Повторы чинят именно это. Остальные практики решают, сколько стоит задача и что агент успеет натворить по дороге.
Какую из этих практик вы ввели только после того, как обожглись?
Серия «AI-инженерия для тех, кто вкатывается»
Это цикл из трёх статей. Ссылка на третью часть появится здесь, когда она выйдет.
-
«AI-инженерия для тех, кто вкатывается: агенты, MCP, токены и кэш с цифрами»
-
«AI-агент в проде для тех, кто вкатывается: инструменты, RAG, надёжность и проверки» (вы читаете её сейчас)
-
«Агентная система для тех, кто вкатывается: цепочка или агент и всё вместе на примере агента поддержки» (в работе)
Источник: habr.com