
Все вокруг говорят про нейросети и те возможности, которые они дают. А многие и полноценно используют их возможности. А я по-прежнему продолжаю работать по старинке, вручную корпя над каждым элементом. И постоянно возникает ощущение, что я какой-то динозавр, который отстаёт от современных трендов.
И неожиданно для себя, я решил немного присоединиться к прогрессу. Нет, не подумайте ничего плохого. По-прежнему — никакого нейрослопа! Агента я по-прежнему не пускаю в мой проект. И не собираюсь. Но вот использовать возможности нейросетей, чтоб сделать игру интереснее (именно интереснее) – вот тут я обоими руками за.
И всё это вылилось в мою работу по внедрению в игру самообучающегося агента для замены существующего глупого бота. И о том, как всё это было и во что вылилось, я и хочу рассказать в данной статье.
Ссылки на видеоверсию статьи: YouTube, RuTube и VK Video.
1. Вступление
Я являюсь разработчиком тактической ККИ про танки в сеттинге второй мировой войны Tank General. В игре реализован ПВП и несколько ПВЕ режимов, в которых как раз и используется существующий бот. Разрабатываю игру уже более 2-х лет и в настоящее время уже постепенно готовлю её к релизу.
Для начала достаточно важный вопрос — а оно тебе вообще надо? ПВЕ режимы в игре есть, бот в них воюет, передвигается, использует заклинания, грамотно расходует ресурсы. Чего еще тебе надо? А сил и времени на разработку самообучающейся модели уйдет немало.
Но на самом деле – надо. Очень надо. В первую очередь по той причине, что ПВП бои в моей игре намного более захватывающие, длительные и напряженные, чем ПВЕ бои против бота. Если совсем проще сказать – то ПВП бои намного более интересные.
И тут возникает определенный нюанс: не все люди любят играть в ПВП. Насколько я понимаю современные игровые тенденции, всё больше людей предпочитают ПВЕ режимы в играх вместо ПВП. Я сам такой человек.
А мне бы хотелось, чтоб в мою игру играли все, кому по душе жанр и сеттинг игры, а не только любители ПВП заруб. И вопрос не только в потенциальных деньгах от большего количества игроков. Просто я люблю свою игру и мне бы хотелось, чтоб как можно больше людей разделили мою любовь.
Когда более 2-х лет назад я реализовывал бота для своей игры, то я понятия не имел, как это делать. И просто прописал для него поведения так, как я это видел — указал основные алгоритмы поведения для каждой конкретной ситуации: последовательность действий, выбор целей, направление движения и т.д. В дальнейшем, при улучшении бота, ему была добавлена система наград, где каждый результат действия бота стоит какое-то количество очков и бот каждый раз должен выбирать действие, которое ему принесет наибольшее количество очков (в теории).
И насколько мой бот получился «умный»? Несмотря на несколько проведенных апгрейдов бота, не особо-то он и умен. И это не удивительно, учитывая ограниченность его реализации. И по-прежнему, чтоб придать ПВЕ бою определенную сложность мне просто приходится увеличивать силу карт бота, делая бои не совсем «честными».
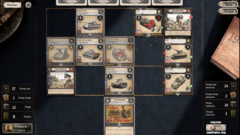
Из-за того, что в игре сотни карт со способностями, а для самого боя реализована сетка игрового поля, в каждом бою возникают сотни вариантов действий, которые крайне сильно отличаются от боя к бою. Из-за этого создаётся очень большая вариативность разных комбинаций действий.
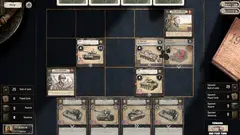 (вот что я имею в виду)
И в конце концов я уперся в выбор: или заниматься постоянным улучшением поведения бота, прописывая для него лучшие варианты поведения для каждой ситуации. Или пойти каким-то иным путём.
Выбрав первый вариант, мне пришлось бы просто бесконечно расширять мои скрипты, отвечающие за алгоритмы поведения бота, пытаясь учесть в них все основные ситуации, которые могут возникнуть в моей игре. А таких ситуаций – тысячи. И еще постараться сделать, чтоб эти алгоритмы не конфликтовали друг с другом.
Можно было пойти по этому пути? Вполне. Хоть это и не особо легко и займет немалое количество времени, но вариант вполне реализуемый.
Только вот уверен, что по итогу всё равно не получится прописать такого бота, чтоб бои с ним ощущались на уровне ПВП боёв. Ограниченность бота в выборе алгоритмов действий, его шаблонные действия в конкретных ситуациях и общая предсказуемость не дадут такого удовольствия, которые ты получаешь в противостоянии с живым человеком.
И не так давно мне пришла в голову идея: а почему бы не попробовать внедрить в игру самообучающуюся модель? Которая проведет сама с собой многие тысячи боёв и научится играть на таком уровне, чтоб противостоять ей было по-настоящему интересно. Кто мне мешает? Никто. Так почему бы это не сделать?
По крайней мере, такие у меня были грандиозные планы. Но всё оказалось не так просто…
2. Стартовые условия.
Как я уже говорил, работать над проектом я предпочитаю по старинке: всё вручную ковыряю, самостоятельно настраивая в движке Юнити каждый элемент. Единственное исключение сделано для работы с кодом игры, так как у меня нет профильного образования и самостоятельно с кодом я работаю крайне плохо и медленно.
Глядя на то, что творят современные вайб-кодеры или ИИ-слопперы, у меня давно возникает ощущение, что я какой-то устаревший дед, который ничего не понимает в современных технологиях и безнадежно отстал от более продвинутой молодежи. И не особо то хочет их догонять, т.к. мне нравится сам процесс создания игры своими ручками и я не хочу его заменять на что-то более продвинутое, быстрое, но бездушное.
Но вот ускорение работы с кодом, которое дали современные агенты, мне очень понравилось. В своё время я пришел в полный восторг от того, насколько это ускорило общую работу. И продолжаю радоваться по сей день.
Что я использую? Так как мне не требуется какой-то навороченный агент с безумным количеством токенов, то я использую бесплатную модель Big Pickle (черт его знает, что под ней скрывается, но работает качественно) или Deep Seek V4.1 через открытый ИИ-агент OpenCode. Выглядит эта работа как какой-то архаизм из 90-х годов. При этом, у OpenCode есть более привычная современная оболочка, но мне, как настоящему деду, просто лень в ней разбираться, так как задачи по работе с кодом прекрасно решает и эта древность.
 Моя текущая версия агента
Каждая задача – это новая сессия. Думаю, не так сложно настроить OpenCode, чтоб он запоминал прежние сессии. Но мне это и не требуется, так как сам проект и так у меня в голове висит и я прекрасно понимаю, куда надо направить агента, чтоб реализовать ту или иную задачу. А для работы с кодом, как правило, вполне хватает ежедневных бесплатных лимитов Big Pickle. На крайний случай, у меня есть второй ПК, на котором я могу продолжить работу над проектом. И на совсем уж крайний вариант – на ПК установлен локальный Qwen 3.8 27B, который, хоть и очень медленно, но тоже неплохо работает через тот же OpenCode.
Но, сразу скажу, реализация самообучающейся модели находится далеко и глубоко за пределами моих знаний и самостоятельно я бы не смог её осуществить. Гляньте только на мою текущую формулу наград для модели, чтоб было понимание, с чем приходится работать:
R_total = R_terminal + R_intermediate
R_terminal = +100 (победа) / −100 (поражение)
R_intermediate = clip( R_combat + R_damage + R_tactical + R_board , −80 , +80 ).
Где: R_combat | clip( λ_c · (Σ_enemy V(u) − β_c · Σ_own V(u)), −C_c, +C_c ) | λ_c = 10, β_c = 1.2, C_c = 70 | ±70 |
| R_damage | clip( λ_d · (Σ_enemy f_d·V(u) − β_d · Σ_own f_d·V(u)), −C_d, +C_d ) | λ_d = 8, β_d = 1.2, C_d = 15 | ±15 |
| R_tactical | сумма бонусов/штрафов (см. §5) | — | ±10 |
| R_board | clip( b_board · Δcells, −C_b, +C_b ) | b_board = 5, C_b = 10 | ±10 |
Класс, да? Вот прям сразу всё становится ясно и понятно, когда смотришь на подобную формулу.
Вот такие стартовые условия. И, к сожалению, даже более чем двух лет работы над проектом оказалось совершенно недостаточно, чтоб было понимание, как реализовать эту самую самообучающуюся модель. Пришлось более глубоко подключать ИИ-агента и нейросеть к работе над данной задачей.
3. Реализация самообучающей модели.
Для начала мой агент получил задание провести полный анализ реализации ведения боя оппонентом-ботом в проекте. После анализа этот же агент составил план работы по внедрению в проект самообучающейся модели, состоящий из 20 последовательных стадий. Этот план был передан Chat GPT и с его помощью был доработан и утвержден. После чего я приступил к непосредственной реализации.
Работа велась следующим образом: я скармливал Chat GPT общий план, отчеты по выполненным стадиям и текущее состояние проекта, после чего просил создать необходимый промт по текущей стадии для моего агента, который и передавал ему. Потом уже агент выполнял поставленную задачу и предоставлял отчет по её завершению. И дальше всё начиналось по новой. Все стадии шли по этой же схеме.
Не скажу, что было легко, прям как по маслу, но в целом работа велась, выявленные ошибки устранялись и постепенно работа всё дальше и дальше продвигалась.
Первым делом была полностью скопирована и вынесена в отдельные скрипты вся механика боя: атака, передвижение, обработка урона, розыгрыш карт и т.д. По сути дела внутри игры была создана еще одна упрощенная игра, но без визуализации.
Следующим этапом был создан скрипт, который мог запускать симуляцию боя, используя все скопированные механики. Именно этот скрипт позволяет запускать симуляцию боя на уровне кода, без визуального отображения, благодаря чему симуляционные бои выполняются очень быстро (каждый из которых длится несколько секунд), но представляют собой полноценные бои.
И только после этого в проект была добавлена обучаемая модель. На данном этапе модель уже умела корректно взаимодействовать с игровой логикой, соблюдать правила и выбирать допустимые действия для атаки или передвижения. Однако полноценного обучения ещё не было: модель знала конечную цель — победу в бою, но пока не умела эффективно выстраивать стратегию её достижения.
Следующий важный шаг – это внедрение непосредственно механизма обучения модели. Сама симуляция боёв уже была реализована, теперь необходимо, чтоб модель не просто гоняла бои, но и реально обучалась на них.
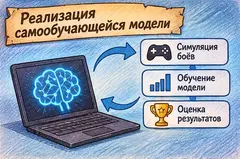
Завершив данную задачу и получив подтверждение, что модель реально обучается по результатам симуляционных боёв я сильно обрадовался и посчитал, что самая сложная часть уже позади.
Какой же я был наивный. Всё только начиналось…
4. Основной затык
Сразу отмечу важный момент. Самообучающиеся модели в моём проекте — это не большие языковые ИИ-модели (вроде Qwen, Chat GPT или Claude), локально интегрированные в игру. Те гиганты обладают совершенно другим функционалом, который для моих задач просто излишен. Они — универсалы, но их возможности нафиг не нужны в моей игре.
Для своего проекта я использую классическое машинное обучение (Machine Learning). Если в двух словах объяснить разницу: в отличие от универсальных нейросетей, мои модели заточены исключительно под конкретную задачу. Для них мира за пределами моей игры не существует. В их основе лежат математические формулы и алгоритмы, которым даётся доступ к игровым функциям. В процессе обучения программа находит оптимальные закономерности и формирует свою собственную базу — это и есть готовая модель.
Но зато в рамках моей игры они будут показывать результат лучше, чем универсальные модели (если, конечно, тех тоже специально не обучить моим правилам). При этом базовые принципы обучения что у классического ML, что у современных больших ИИ примерно одинаковы — разница лишь в архитектуре и в объёме информации, используемой для обучения.
Так вот, для обучения были созданы две параллельные базовые модели А и В, каждая из которых обучается отдельно. Непосредственно сам процесс обучения моделей проходит следующим образом:
— базовые модели А и В замораживаются как фиксированные модели.
— кандидат А (копия модели А с настройкой самообучения) проводит много боев с фиксированными моделями А и В;
— кандидат В (копия модели В с настройкой самообучения) проводит много боев с фиксированными моделями А и В;
— напоследок уже 2 обученных кандидата А и В проводят бои между собой;
— в случае, если зафиксирован прогресс, то эти обученные модели заменяют собой замороженные модели А и В и цикл начинается по новой.
Ключевая проблема началась с того, что первый серьезный прогон симуляционных боёв в несколько тысяч матчей показал, что модели реально обучаются. Но обучаются проигрывать, так как процент побед у обученных моделей в боях против базовых моделей резко упал (50% побед в начале обучения и 30% побед в конце обучения).
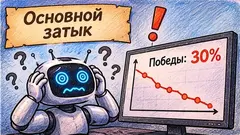
То есть эксперимент наглядно показал, что модели реально обучаются по результатам боёв. Но обучаются они не совсем тому, чего я от них ожидал.
Начал разбираться. Обнаружил, что в конце формулы стоял неверный знак, который менял цель обучения на противоположную. Т.е. модель реально училась не выигрывать, а проигрывать. Исправил. Процент побед обученных кандидатов против базовых моделей вернулся к 50%.
Но вот дальше – всё застопорилось. Тысячи и тысячи боёв, многочисленные корректировки моей первоначальной формулы ни к чему не приводят – анализ боёв показывал, что само обучение ведётся (контрольные веса моделей меняются), но это не даёт никакого видимого результата – процент побед не растёт, он так и остаётся в районе 50%.
Если на реализацию симуляции боёв и подготовку моделей к обучению я потратил около 10 дней, то на многочисленные попытки научить модели показывать реальный результат, который бы фиксировался в виде побед, у меня ушло примерно столько же времени, но уже с нулевым результатом. Что бы я не делал (а я упорный), результат был тем же – симуляции, запущенные на тысячах боёв, не давали никакого прогресса: процент побед стабильно не менялся.
Думаю те, кто сталкивался с самообучающими моделями, уже поняли, где я протупил. А я даже не догадывался об этом….
И тут кожаные мешки в очередной раз доказали, что нас еще рано сбрасывать со счетов. Есть еще порох в пороховницах и мы еще можем пригодиться в наступающем новом мире!
5. Выход из тупика
Указанный затык был полностью вызван моей глупостью. Но и хваленые нейросети тоже не смогли подсказать, где моя главная ошибка. Причем, я даже обращался к разным нейросетям (тому же Claude ставил задачу, в надежде, что он разберется и укажет на причину отсутствия прогресса в обучении), а всё без толку!
И эти «умнейшие» нейросети, которые знают о разработке игр и о работе с обучающимися моделями не в тысячи, а десятки, а то и сотни тысяч раз больше меня, так и не смогли указать на мою ключевую ошибку.
А ошибка была очень простая: я сделал процент побед единственным критерием успешности обучения.
Мне изначально казалось, что это правильный критерий. А как еще оценивать результат обучения, как не в наиболее наглядном выражении в виде увеличения процента побед у обученных моделей в сравнении с базовыми?
И это оказалось в корне неверно. Почему?
Подсказку я получил совсем не там, где я ожидал. В разговоре с другом, который не имеет никакого отношения к геймдеву, но любит смотреть разные видео по современным трендам в прогрессе науки (в том числе и видео о работе с нейросетями), я пожаловался ему на тупик в обучении. И друг, в самом конце разговора, вспомнил, что не так давно смотрел видео, где какой-то инди-разработчик встраивал самообучающуюся модель в создаваемую им гоночную игру. И этот разработчик критерием успешности обучения моделей изначально поставил такую цель, как победа в заезде. И у него тоже ничего не получалось, т.к. он пошел по тому же пути, что и я.
А всё сдвинулось с мертвой точки только, когда он стал разбивать обучение модели на отдельные этапы. То есть модель получала вознаграждение не за завершение всего заезда, а за успешный проезд каждого отдельного поворота или препятствия. Тогда как в изначальной версии обучения, когда награда модели начислялась только за полное завершение заезда, машины даже не доезжали до финиша.
Вот оно, то самое! У меня прям в голове сразу щелкнуло. Это и есть моя основная ошибка!
Проблема заключалась в том, что модель получала основное и единственное вознаграждение только за конечный результат — победу или поражение, которая достигается через уничтожение штаба противника. При этом между началом боя и уничтожением вражеского штаба происходит огромное количество промежуточных действий: размещение карт с руки, выбор куда перемещаться и кого атаковать, розыгрыш карт заклинаний, использование способностей карт, накопление ресурсов для розыгрыша карт и т.д. И в моей начальной реализации каждое из этих не получало никакой дополнительной оценки.
И с чего это я решил, что моя модель будет всеми этими телодвижениями заниматься, если у неё есть итоговая цель – победа через уничтожение штаба? Вот модель и реализовывала эту цель самым простым способом – уничтожала штаб противника прямыми атаками, полностью положив болт какую-либо тактику или иные механики: она просто всегда атаковала штаб противника своим штабом и все размещенные карты тупо ехали к штабу и пытались его атаковать.
Из-за того, что обучение у меня велось на тренировочных штабах, у которых показатели урона и прочности одинаковы для всех наций, то победу одерживал тот штаб, который начинал ход первый и первым наносил урон вражескому штабу. А так в симуляции у меня реализована механика чередования стороны, которая ходит первой, то и получалось, что модели одерживали победы по очереди, в зависимости от того, чей ход начинался первым.
Этим и объяснялось отсутствие прогресса и общий процент боёв по итогу обучения в 50% для всех вариантов обучения.
Сам не понимаю, с какого такого бодуна я решил, что модель сама по себе окажется разумной и будет использовать более сложные варианты для победы, чем прямое уничтожение штаба? Как будто бы я сам не понимал, что ИИ-мозги это не полноценные мозги, а лишь их имитация и кладезь знаний? Понимал, но всё равно потратил кучу времени на абсолютно бесполезную работу.
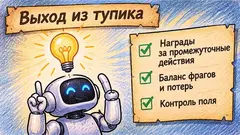
Зато кожаный мешок, даже не разбирался в теме, сходу смог найти потенциальную причину ошибки, просто вспомнив эпизод когда-то просмотренного видео!
6. Что дальше?
В моей игре уничтожить вражеский штаб и тем самым победить в бою можно разными способами. Например – собрав колоду, которая заточена именно на уничтожение вражеского штаба. Но самый популярный способ (и предпочитаемый мною) – это контроль поля боя, который достигается через эффективное уничтожение размещенных противником карт танков.
И по моей новой задумке модель должна научиться побеждать именно через эффективный контроль поля боя. Поэтому я откорректировал формулу наград для модели путём добавления в неё наград за количество уничтоженных карт техник противника и штраф за потерю своих карт. Теперь моя формула наград стала выглядеть следующим образом: R = episode_reward + 0.6 clip(kills - 1.2 losses, -3, +3), что позволяло награждать модели за положительный баланс фрагов.
При этом, чтобы модель не забывала про главную цель боя – победы в бою, дополнительное награждения за фраги было выставлено значительным, но уступающим награде за уничтожение вражеского штаба. Иначе возникал риск, что для набора очков модель будет бесконечно уничтожать выставляемые противником карты, не стремясь к достижению победы.
И это дало результат. Теперь модели при обучении стабильно начали выходить в плюс относительно базовых моделей по соотношению фрагов и потерь. Что, наконец, позволило мне заменять базовые модели на обученные, получая, таким образом, прогресс в обучении.
Однако, не смотря на полученный результат, мне было ясно, что данных изменений недостаточно. А использование положительного баланса уничтоженных и потерянных карт в виде основного критерия эффективности обучения не давало уверенности, что итоговый результат обучения моделей будет меня устраивать.
Результатом нового мозгового штурма стала очередная корректировка формулы наград, которая теперь выглядит так, как я показывал ранее. Новая система вознаграждений уже учитывает разные игровые ситуации:
— Безответное уничтожение (цель уничтожена, а атакующий (юнит) не потерял HP);
— Уничтожение САУ с дистанции (когда атакующий САУ и цель уничтожена);
— Уничтожение штабом с дистанции (то же самое, но для штаба);
— Убийство ПТ-САУ первым ударом (это позволяет награждать за использование игровой механики ПТ-САУ, которая не получает ответный урон если цель уничтожена при атаке);
— Убийство тяжёлого танка в кулдауне (еще одна награда за использование игровых механик тяжелого танка);
— Неудачная атака (в результате действия погиб свой юнит, при этом не уничтожено/не повреждено ни одного врага);
— Урон по вражескому штабу (постоянный небольшой бонус);
— Контроль плацдарма противника (чтоб игроку было тяжелее разыгрывать карты с руки).
Результаты прогонов по новой системе наград показались мне достаточно обнадеживающими. Все дополнительные показатели стабильно растут по итогам прогонов и обучаемые модели показывают преимущество в этих показателях над базовыми моделями.
Конечно, пока еще рано делать безусловные выводы о будущей успешности всей работы по созданию по-настоящему «умных» моделей. Но теперь уверенности в положительном результате стало намного больше.
Казалось бы, наконец-то я разобрался с основными проблемами обучения и теперь можно спокойно двигаться дальше. Но кто мне мешает опять наступить на те же грабли? Правильно – никто!
7. Затык № 2
Куда же без еще одного затыка? И как вы думаете, чем они был вызван? Правильно — я опять слишком поздно начал думать! Я снова доверился нейросети и опять сделал это зря. Не будьте как я – думайте, что вы делаете! Надеюсь, это будет очередным наглядным уроком, как не надо делать.
Как уже говорил, изначально я неверно выбрал критерием успешности обучения моделей такой параметр – как рост процента побед у обученных моделей против базовых. В дальнейшем, при изменении системы наград, модели стали более точечно обучаться и стал виден их прогресс.
Но я по-прежнему ориентировался на показатель процента побед как итоговое подтверждение эффективности обучения. Но процент побед у обученных моделей в боях против базовых, как и прежде, колебался в пределах статистической погрешности.
И каждый раз после очередного обучения нейросеть тыкала меня в итоговый отчет, убеждая, что по-прежнему нет доказанной эффективности обучения моделей, т.к. процент побед почти не менялся. И мы с нейросетью очень много времени потратили на обсуждение того, что можно подкорректировать в настройках обучения для увеличения показателя побед у обученных моделей.
Коллективно «обсуждали»! «Коллеги», епт! Ладно нейросеть, она не имеет мозгов, что с неё возьмешь? Но я то как мог так тупить!
Основная ошибка аналитики выражалась в том, что каждый раз сравнение эффективности обученных моделей проводилось в боях против базовых моделей, а базовые модели обновлялись каждый день после каждого успешного обучения!
Таким образом, фактически происходило сравнение каждой новой версией модели не с первоначальным уровнем её возможностей, а с практически такой же моделью, которая просто отставала на один цикл обучения.
И естественно, что разница между обученной моделью и точно такой же моделью, но которая провела всего на один цикл обучения меньше, была ничтожной! Достаточно было хоть на немного включить мозг и подумать, а с какого бодуна возьмется заметная разница, если это практически одни и те же модели, т.к. после каждого нового обучения я заменял базовые модели на обученные?
Естественно, после осознания данного совсем не сложного факта, я сразу создал отдельные контрольные модели, которые не будут обновляться и станут выступать в качестве подопытных мышей. Эти контрольные модели были встроены мою систему обучения и именно на них будет проверяться эффективность уже обученных моделей.
8. Заключение
В настоящее время процесс обучения моделей идёт полным ходом (а это небыстрое дело). Параллельно осуществляю встраивание самого механизма обучения непосредственно внутрь проекта, что запускать процесс обучения непосредственно с движка проекта. Также время от времени я корректирую систему наград, чтоб модель училась грамотно использовать разные игровые механики, а не просто совершать телодвижения во время боя. И мне очень хочется верить, что это всё больше приближает меня к главной цели – получить достаточно «умную» модель, чтоб она могла дать настоящий бой реальному человеку.
Думаю, у многих возникнет вопрос – а на какой ляд ты вообще написал данную статью, если у самого еще работа по обучению модели не завершена?
В более ранних статьях я уже озвучивал такую мысль, что разработка каждого игрового проекта слишком индивидуальна, чтоб учиться реализации отдельных механик игры на других проектах, даже в сходных жанрах. Поэтому давать подробную инструкцию по внедрению самообучающегося агента в вашу игру не имеет смысла: она вряд ли окажется полезной для вашего конкретного проекта.
Но вот совершенные мною ошибки являются универсальными и очень даже наглядными. Они могут возникнуть у каждого, кто слишком надеется на «мозги» нейросетей в своей работе.
И было бы здорово, если моя статья поможет кому-то, кто уже создаёт обучающуюся модель в своей игре или кто задумывается о том, стоит ли добавлять в его проект самообучающуюся модель. А может, у кого-то появится мысль тоже добавь самообучающуюся модель в свою игру.
Пусть эта помощь будет не в виде пошаговой инструкций, а в виде донесения главной мысли:
— даже (особенно) при использовании нейросетей, думай о том, что ты делаешь!
Очень надеюсь, что моя статья поможет вам не терять время на бесполезную работу, как это произошло у меня. Помните, что именно ваши мозги должны быть главным инструментом в работе и именно от использования своего серого вещества зависит итоговый результат подобной работы.
Спасибо, кто дочитал статью до конца.
Также буду благодарен за любые конструктивные советы и указания тех ошибок, что я допустил в своей работе.
Всем удачи.
п.с. Ссылка на демо моей игры в Steam и на чат в Телеграмме по игре.
п.с.с. И по традиции несколько скриншотов с моей игры
Источник: habr.com