
 *RTFM: Read The F*** Manual
Всем привет! Я технический директор Документерры. Мы делаем платформу для сайтов документации, так что о документации я могу говорить часами. Но сегодня история не про продукт. Она про то, как документация, которую тестировщики раньше проверяли по остаточному принципу, превратилась в главный источник для их автотестов.
Как было
Сколько я пишу софт, документация жила в самом конце конвейера. Написали код, выкатили фичу, кто-то её описал. Читали документацию клиенты. Внутри компании она была нужна примерно никому: разработчики и так знают, как всё работает (по крайней мере, им так кажется), а тестировщиков просили проверять её в качестве одолжения, когда найдётся время. Время, как вы понимаете, находилось редко.
Как стало
В этом году у документации появился читатель внутри компании. Тестировщики начали отдавать её Claude и получать из неё тест-кейсы и автотесты. Документация переехала из конца конвейера в начало: теперь с неё начинается тестирование.
Вот что мы теперь умеем. В начале 2025 года половину этого списка я бы счёл чересчур оптимистичной.
-
Автотесты без возни с селекторами. Час промптинга, пять часов работы Claude, и у нас рабочие автотесты на фичу. Селекторы никто не подбирает, шаги руками не придумывает. На входе только описание тест-кейсов.
-
Тесты на недоделанную фичу. Пишем и чиним тесты, отдавая модели документацию. Если новая фича опирается на старую функциональность, тест, который готовит предусловия, можно написать ещё до того, как появится новая часть.
-
«Протестируй и напиши автотесты». Даём модели новую фичу, PR, задачу в Jira и документацию. Сначала вручную прокликивать фичу, чтобы понять, как она работает и что в ней проверять, больше не нужно.
-
Тесты на фичу, которую тестировщик в глаза не видел. Если на неё есть документация, Claude разберётся.
-
Охота на устаревшие тест-кейсы. Находим ручные и автоматизированные тест-кейсы, которые противоречат текущей документации, и обновляем их.
-
Баги в нагрузку. Модель обычно понимает, что наткнулась на баг: по тест-кейсам, по документации или по банальной логике (вылезла ошибка, кнопка не нажимается). Ещё один источник багов — разбор логов прогонов.
Как это выглядит на практике, покажу на простой фиче: восстановлении пароля.
Шаг 1. Документация. Модель получила через MCP-сервер вот такой фрагмент:
-
Откройте портал и нажмите кнопку Войти, чтобы перейти на страницу входа.
-
На странице входа нажмите Забыли пароль?.
-
На странице восстановления пароля введите свой логин или адрес электронной почты, привязанный к вашей учетной записи, и нажмите Сбросить пароль.
-
Вы получите письмо по электронной почте со ссылкой для установки нового пароля.
Шаг 2. Тест-кейсы. Их составил ИИ-агент. Предусловие для обоих: пользователь не авторизован.
TC-1. Ссылка «Забыли пароль?» открывает страницу восстановления (шаги 1–2 из документации)
Шаг
Ожидаемый результат
1. Открыть /login/
На форме входа есть ссылка Забыли пароль?
2. Нажать Забыли пароль?
Открыта страница /forgot-password/ с полем логина и кнопкой Сбросить пароль
TC-2. Без логина запрос на сброс не отправляется (шаг 3, негативный)
Шаг
Ожидаемый результат
1. Открыть /forgot-password/
Поле логина пустое
2. Нажать Сбросить пароль, не вводя логин
У поля появилась ошибка валидации, страница не сменилась
Обратите внимание на TC-2: про пустой логин в документации ни слова. Негативный кейс модель вывела сама, из обычной логики формы.
Шаг 3. Автотест.
import {test, expect} from '@/fixtures/test';import {ForgotPasswordPage} from '@/pages/Application/forgotPassword.page';test.use({storageState: {cookies: [], origins: []}}); // anonymous usertest('TC-1: "Forgot password?" opens the recovery page', async ({page}) => { const forgot = new ForgotPasswordPage(page); await test.step('1. Open the login page', async () => { await page.goto('/login/'); await expect(forgot.linkOnLoginPage).toBeVisible(); }); await test.step('2. Click "Forgot password?"', async () => { await forgot.linkOnLoginPage.click(); await expect(page).toHaveURL(//forgot-password/$/); await expect(forgot.loginInput).toBeVisible(); await expect(forgot.resetButton).toBeVisible(); });});test('TC-2: an empty login is not submitted', async ({page}) => { const forgot = new ForgotPasswordPage(page); await test.step('1. Open the recovery page', async () => { await forgot.goto(); await expect(forgot.loginInput).toHaveValue(''); }); await test.step('2. Click "Reset password" without a login', async () => { await forgot.resetButton.click(); await expect(forgot.loginError).toBeVisible(); await expect(page).toHaveURL(//forgot-password/$/); });});Конвейер, или где мы не доверяем нейронке
Из всего этого сложилась такая цепочка:
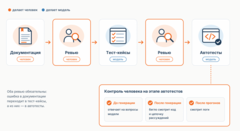 Два обязательных ревью и контроль на этапе автотестов: модель пишет тест-кейсы и код, но решения остаются за человеком.
Здесь два гейта ревью. Оба ручные, и ни один нельзя пропустить. Объясню почему.
Ревью документации. Всё, что ниже по цепочке, наследует её содержимое. Если документация описывает поведение, которого в продукте уже нет, тест-кейсы его закрепят, а автотесты начнут его проверять. Получается классика: две системы согласны друг с другом, и обе неправы. Тесты зелёные, все довольны, а продукт тем временем тихо уезжает в сторону.
Ревью тест-кейсов. Этот гейт дешевле и ловит другое: дыры в покрытии. Человек, который знает, что клиенты делают с продуктом, видит их сразу. Модель, которая работает с текстом, не видит.
Третий этап требует меньше контроля, чем я ожидал. И неожиданный вывод: цепочку рассуждений читать полезнее, чем сгенерированный код. По ней видно, что модель думала о продукте до того, как написала первую строчку. Если она где-то неправильно поняла фичу, это видно сразу, без раскопок в коде.
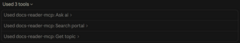 При ревью сразу видно, откуда модель брала сведения о продукте. Здесь она сначала задала вопрос ИИ Помощнику портала, затем поискала по порталу и открыла нужную страницу документации
«А почему не просто экспорт?»
Тестировщики читают документацию через MCP-сервер опубликованной документации Документерры. Первый вопрос, который нам задают: зачем MCP, если документацию можно просто выгрузить? Причин четыре.
-
Объём и охват. Для закрытой документации большого объёма MCP, по сути, единственный рабочий способ. Выгрузить можно, но это долго и муторно, а после определённого размера не получается вовсе. И главное: когда тест-кейс затрагивает несколько связанных частей продукта, никто заранее не знает, какие страницы понадобятся. Приходится либо выгружать всё, либо гадать. Через MCP модель сама находит нужное.
-
Закрытая документация. Многое из того, что нужно тестировщикам, пользователям ещё не открыто. Фичу тестируют до релиза, значит, документация к ней пока внутренняя. Сценарии экспорта обычно рассчитаны на уже открытый контент. А MCP-сервер отдаёт и такие страницы: документацию к фичам до релиза мы держим в закрытых публикациях, и через сервер её читают только те, у кого есть доступ.
-
Актуальность. Самое важное. Когда модель читает через MCP, я знаю, что она работает с нашей текущей документацией, а не с тем, что запомнила при обучении или нашла в случайной статье о нашем продукте. И это проверяемо: в цепочке рассуждений видно, когда модель обращалась к MCP-серверу.
-
Люди не умеют объяснять. Четвёртая причина к инструментам отношения не имеет. Попросите инженера написать для модели контекст, и получите что-то неполное. Не потому, что инженер плохой, а потому, что он знает слишком много и не замечает, что пропустил. Документацию писали для того, кто не знает. Поэтому как источник контекста она лучше, чем человек, который знает.
Подключение сервера выглядит так:
"mcpServers": { "docs-reader-mcp": { "command": "npx", "args": [ "mcp-remote", "https://ИМЯ-ПОРТАЛА.documenterra.net/published-docs-mcp-server" ] }}Работа над новой фичей начинается со скилла test-design, который мы сделали для ИИ-агента. Ему передаёшь всё, что известно о фиче: How to test от разработчика, ссылку на задачу, pull request, уже существующие тест-кейсы или просто описание задачи своими словами. Документацию по продукту он читает сам через MCP. На выходе получается готовый тест-план с тест-кейсами, по которому потом пишется автоматизация. Запуск выглядит так:
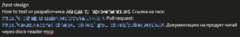 Запуск скилла test-design: заметки разработчика, задача, PR и указание читать документацию через MCP-сервер
Какую документацию любит нейронка
Тут опыт тестировщиков заставил меня пересмотреть представления о хорошей документации.
Для тестирования документация делает две вещи. Она описывает, как продукт должен себя вести, и из этого получаются тест-кейсы. И она описывает, как совершать в продукте популярные действия. Это помогает модели сориентироваться в интерфейсе и раскрывать высокоуровневые кейсы вроде «создать проект и опубликовать его».
А теперь о том, что именно делает документацию пригодной для машины.
Ограничения, а не описания.
Бесполезно для тестов
Готовый тест-кейс
Система обрабатывает файл
Файлы больше 50 МБ отклоняются с ошибкой 413
Каждая точно названная граница становится проверкой, которую никому не придётся придумывать.
А вот как это выглядит в жизни: формулировка кажется точной, но модель находит в ней три вопроса, без ответа на которые тест не напишешь.
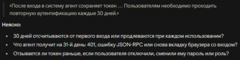 Да, это наша собственная документация. Мы делаем платформу для документации и тоже пишем «каждые 30 дней», искренне считая это точной формулировкой.
Сценарии, а не кнопки. Страница о том, где какие кнопки, устаревает при первом же изменении интерфейса, и вместе с ней ломается каждый выведенный из неё тест. Страница о том, чего пользователь хочет добиться, переживает редизайн. И тест переживает: модель заново выводит шаги под новый интерфейс, потому что знает, куда нужно прийти.
Наши техписы годами топили за документацию, построенную вокруг задач пользователя. Их довод: клиент приходит с задачей, а не из любопытства к меню. Я кивал, соглашался и считал это вопросом вкуса. Оказалось, что от этого зависит, переживёт ли набор тестов редизайн. Коллеги, вы были правы.
Release notes. Они говорят, что изменилось, а значит, что перегенерировать или чинить. Без них пришлось бы сравнивать поведение и выяснять, что сдвинулось.
Писать больше не нужно. Нужно писать точнее там, где раньше размытость сходила с рук.
Кто теперь заботится о документации
Годами отношения между документацией и тестированием работали в одну сторону: тестировщики проверяли документацию из вежливости. Теперь всё наоборот. Документация стала входными данными для их собственной работы, и от её качества напрямую зависит, сколько автоматизации придётся переписывать каждый квартал. У тестировщиков появилась своя, вполне шкурная причина о ней заботиться.
С разработкой начинается то же самое, хотя там мы пока в начале пути. Мы планируем, что Claude будет заглядывать в публичную документацию во время разработки: когда сомневается, чтобы не ломать обратную совместимость и чтобы понимать, что пользователи на самом деле делают с фичей. По сути, документация описывает ожидаемое поведение продукта. До настоящей спецификации ей далеко: она высокоуровневая и неподробная. Но для большинства фич другого описания просто нет, и это лучше, чем ничего.
Мне кажется, это касается не только нас. Если документация питает генерацию тестов, ответы поддержки и внутренние инструменты, спор о том, стоит ли её поддерживать, перестаёт быть спором о ремесле. Она становится статьёй расходов, исчезновение которой заметят сразу несколько команд.
Что пока не взлетело
MCP-сервером мы пользуемся недолго, так что всё написанное выше — ранние результаты, а не устоявшаяся практика.
Картинки. В нашей документации есть скриншоты, и часть информации на них не продублирована в тексте. MCP-сервер возвращает Markdown со ссылками на изображения, но делает ли нейронка с ними что-то полезное, мы не проверяли. Если заметная часть знаний о вашем продукте живёт в скриншотах, пока считайте, что для такого конвейера их нет.
Цикличность. Повторю, потому что это самый дорогой риск. Документация порождает тест-кейсы, тест-кейсы закрепляют поведение. Если ничто в этой петле не привязано к самому продукту, обе стороны могут уехать вместе, в полном согласии друг с другом. Для этого и нужен ручной гейт ревью, и убирать его ради экономии времени я бы не стал.
Вместо заключения
Главное, что я вынес из этого года: документация перестала быть отчётом о сделанной работе и стала инструментом для следующей. И впервые у неё появились внутренние читатели, которым она нужна не из вежливости.
А вы уже отдаёте документацию нейронкам? Особенно интересно, если кто-то научил модель нормально работать со скриншотами из доков. Расскажите в комментариях, нам это правда нужно.
Источник: habr.com