
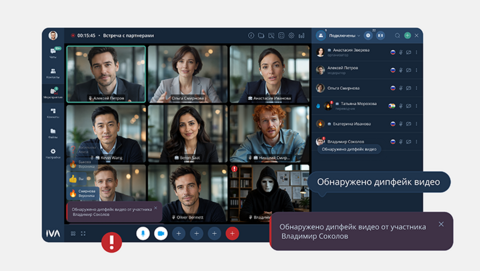
Привет, Хабр! Меня зовут Татьяна Дешкина, я замдиректора по развитию продуктов в VisionLabs. Вместе с Дмитрием Журавлёвым, директором продукта IVA MCU в IVA Technologies, мы расскажем, как детектор дипфейков VisionLabs защищает видеозвонки на платформе IVA MCU: какими бывают дипфейки, как устроена детекция и почему она нужна, даже если у вас уже настроена вроде бы надёжная защита ВКС.
Но прежде чем перейти к кейсу, дам короткую вводную лекцию о проблеме и технологии.
Дипфейки ближе, чем вам кажется
Сегодня недостаточно просто подключиться по ссылке — нужно быть уверенным, с кем именно вы общаетесь. Мошенники освоили цифровую маскировку, и речь давно не только о бытовых сценариях типа «мама, я попал в аварию, скинь денег на карту». Дипфейки используют не только для разового выманивания денег у частного лица, но и для проникновения на корпоративные онлайн-встречи — чтобы выудить конфиденциальные данные, получить доступ к аккаунтам или заключить фиктивные сделки на суммы, которые бытовому мошенничеству и не снились.
Показательный кейс: в феврале 2024 года мошенники обманули филиал международной компании в Гонконге, создав дипфейк-версию финансового директора. В результате видеозвонка с «руководителем» были незаконно переведены $25,6 млн.
О таких историях слышно куда реже, чем о звонках мошенников бабушкам, и дело не в том, что они редкость. Как и банки, которые добровольно редко когда выпускают в публичное поле взломы, компании, пострадавшие от дипфейк-атак, почти не афишируют инциденты. Огласка бьёт по репутации, привлекает внимание регуляторов, инициирует активность конкурентов и потенциально провоцирует новую волну атак на ту же организацию: злоумышленники увидят, что схема сработала. Поэтому большинство таких случаев либо не выходит за пределы внутреннего разбирательства и страховых выплат, либо просачивается в публичное поле только тогда, когда скрыть уже не получается, — как в кейсе с Гонконгом.
Сценариев много — от подмены сотрудника на внутреннем созвоне до фейкового клиента, подтверждающего банковскую операцию. Чем больше операций переходит в онлайн, тем выше риск цифровой подмены.
Как работают дипфейки
Дипфейк — сгенерированный с помощью нейросети визуальный или аудиоконтент. На текущий момент наиболее популярны диффузионные модели, также можно встретить GAN/StyleGAN для создания дипфейков лиц. Технологию используют как в безобидных целях (например, в медиа для дубляжа), так и для атак с подменой личности: финансового мошенничества, обхода биометрической верификации, ударов по репутации.
Мы работаем как с визуальными, так и с аудиодипфейками. Внутри каждой из этих модальностей скрывается свой набор методов генерации. Свели их все в таблицу с кратким описанием.
Тип дипфейка
Описание
Реализация
Визуальные дипфейки
Замена лица (face swap)
Суть технологии в том, чтобы извлечь лицо донора (того, кого имитируют) и наложить его на лицо реципиента (того, чьё лицо заменяется) в видео или на фото.
Классическая схема: пара автоэнкодеров с общим энкодером и раздельными декодерами. Один учится восстанавливать лицо донора, второй — лицо реципиента. На инференсе лицо из кадра реципиента кодируют общим энкодером, а полученный латентный код с позой и мимикой отдаётся декодеру донора. Получается лицо донора с мимикой и ракурсом реципиента, и его вклеивают обратно в кадр. Поверх часто добавляют GAN-дискриминатор: он заставляет модель прорисовывать мелкие детали лица вместо размытой картинки. Цвет и освещение подгоняются под видео реципиента уже при вклейке. Обычно каждый кадр обрабатывается отдельно, поэтому лицо в таких видео может дрожать и мерцать. В более современных подходах уже не нужно делать обучение под конкретную пару людей — достаточно одной фотографии донора.
Перенос мимики (face reenactment)
Лицо донора остаётся на экране, но выражение лица, движения рта и даже моргание управляются на основе движений другого человека.
Образ человека на видео сохраняется, но его мимику и повороты головы задаёт другое, управляющее, видео. Обычно управление мимикой и позой реализовано через ключевые точки лица, параметры 3D-модели лица или карту движения, по которой деформируется лицо. Частный случай — синхронизация губ (lip sync), когда модель генерирует движения рта под конкретную аудиодорожку. Здесь движением управляет аудиодорожка, и модель перерисовывает только нижнюю часть лица. Такие модели обучают на парах речь — видео говорящего человека.
Синтез лица (face synthesis)
Генерация несуществующего, полностью синтетического лица.
Генерация фотореалистичного лица несуществующего человека. Типичный результат StyleGAN-подобных архитектур или диффузионных моделей. Модель обучается на больших датасетах с лицами и генерирует новые сэмплы из латентного пространства. Мошенники используют их для создания фейковых аккаунтов или обхода систем верификации, где требуется уникальный, не встречавшийся в базах внешний вид.
Аудиодипфейки
Реплей-атака (replay attack)
Воспроизведение ранее записанного аудиофрагмента.
Ноль генеративных моделей — просто повторное воспроизведение уже записанного реального аудио (голосовое сообщение, фрагмент звонка, запись с автоответчика). Не позволяет менять текст или адаптировать реплику под ситуацию, поэтому это скорее базовый уровень атаки, который детектируется проще всего.
Клонирование голоса (voice cloning)
Генерация речи на основе образца настоящего голоса.
Из нескольких секунд референсного аудио модель извлекает эмбеддинг диктора, описывающий тембр, высоту и другие индивидуальные характеристики голоса. Затем модель использует его как условие при синтезе произвольного текста. Современные модели опираются на саму запись как на образец и перенимают ещё манеру речи и эмоции. Итог — новые фразы голосом конкретного человека, которые он никогда не произносил.
Синтезированный голос (speech synthesis)
Генерация голоса без участия конкретного спикера.
Классический нейросетевой TTS-пайплайн без привязки к конкретному диктору: текстовый энкодер → акустическая модель, предсказывающая мел-спектрограмму → вокодер, превращающий спектрограмму в звуковую волну. Голос при этом может быть стилизован под пол, акцент или эмоциональную окраску. В этом нейросетевой синтез гибче старых конкатенативных систем, которые склеивали заранее записанные фрагменты.
Преобразование голоса (voice conversion)
Замена голоса в уже существующей записи.
Модель меняет тембральные характеристики исходной записи (например, приводит женский голос к мужскому или меняет акцент), сохраняя лингвистическое содержание и просодию фразы. То есть саму структуру речи она не трогает — меняется только окраска звучания.
Наша технология детекции дипфейков распознаёт все перечисленные типы визуальных подделок. В основе — глубокие нейросети, обученные на больших размеченных выборках реальных и синтетических данных. Модель ищет статистические артефакты генерации, невидимые невооружённым глазом.
За аудиодипфейки отвечает отдельный модуль антиспуфинга, встроенный в платформу Audiogram от MWS AI. Но поскольку в кейсе с IVA Technologies речь идёт именно о распознавании по изображению, подробный разбор антиспуфинга оставим для отдельной публикации. К слову, за счёт этого модуля возможен мультимодальный анализ: детектор может одновременно проверять лицо и голос спикера, что повышает устойчивость к комплексным атакам, где подделываются оба потока.
Детектор дипфейков работает в связке с проверкой liveness и детектором виртуальных камер. Проверка liveness защищает от физических фейков, определяя, что перед камерой реальный человек, а не распечатанное фото, видео с телефона или маска. Дипфейк-детекция же используется только для защиты от инъекционных атак и цифровых фейков. Виртуальные камеры — это специализированное ПО для подмены видеопотока, которое часто используется при дипфейк-атаках, соответственно, его тоже нужно обнаруживать.
Детектор может работать в режиме реального времени — с видеопотоком и изображениями, и постфактум — на изображениях и видеофайлах.
Точность детектора в промышленной эксплуатации достигает 99,3% (ROC-AUC). Модель обучена работать на разных кодеках и степенях сжатия изображений, подходит для работы с несколькими лицами в кадре и при дополнительных атрибутах лиц (например, если человек в очках).
Поставляется детектор в Docker и Kubernetes: два варианта поставки позволяют развернуть систему в корпоративной инфраструктуре, масштабировать и обрабатывать большие объёмы данных.
Источник: habr.com