
«Лаборатория Числитель» представила редакцию контейнерной платформы «Штурвал» для ML- и AI-нагрузок — «Штурвал ML/AI», которая запускает задачи на CPU и GPU в одном кластере, включая LLM, например, Qwen и DeepSeek, и, по словам разработчика, позволяет сократить затраты на GPU и эксплуатацию до 80 %. Драйверы, GPU-оператор, Kubeflow, MLflow и средства безопасности обновляются вместе с кластером.
Платформа позволяет сократить простой ускорителей с помощью готовой интеграции инструментов MLOps с корпоративной Kubernetes-платформой, говорит разработчик. Собрав общий пул вычислительных ресурсов, платформа делит совместимые ускорители на независимые вычислительные экземпляры с помощью технологии NVIDIA Multi-Instance GPU (MIG), квотирует ресурсы между командами и отслеживает загрузку ускорителей.
«Штурвал ML/AI» также предоставляет:
Источник изображения: «Лаборатория Числитель»
Ядро, среда containerd, Kubernetes и ML-стек обновляются вместе. ML-кластеры, песочницы и продуктивные среды создаются и отслеживаются из одного кластера управления. Доступ организован с помощью технологии SSO (протоколы LDAP/OIDC) и единого управления доступом на основе ролей (RBAC): права на Kubeflow выдаются в интерфейсе платформы вместе с доступом к кластеру; пользователи входят под корпоративной учётной записью.
Образы сканирует универсальный сканер безопасности Trivy, в том числе по базе уязвимостей ФСТЭК; движок Kyverno применяет политики для подов ML-нагрузок. События аудита уходят в SIEM-систему и Elasticsearch с использованием протокола syslog. Платформа работает в закрытом контуре: установка и обновления выполняются из зеркала образов.
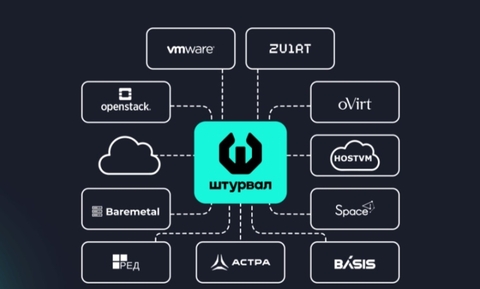
«Штурвал ML/AI» поддерживает гибридные сценарии развёртывания. Заказчик может использовать виртуальные машины (zVirt, vSphere, OpenStack или Yandex Cloud) для обычных вычислительных нагрузок, а физические серверы с GPU — для обучения и запуска ИИ-моделей. Каждая группа узлов настраивается автоматически под свой тип и масштабируется по нагрузке, для управления кластерами используется единый интерфейс. Поддерживаются платформы Astra Linux, РЕД ОС, Rosa, Alt Linux, Ubuntu, Debian; стек рассчитан на ускорители NVIDIA A100, H100 и L40S.
Целевая аудитория «Штурвал ML/AI» включает DevOps-инженеров и платформенные команды, ML-инженеров, специалистов по ИБ и организации с требованиями регуляторов. Платформа работает в закрытом контуре, с единой моделью прав, сканированием образов по базе ФСТЭК и передачей событий аудита во внешние системы.
Источник: servernews.ru