
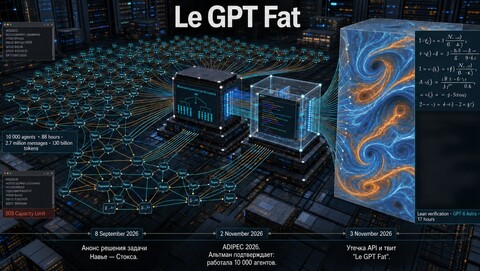
3 ноября инженер OpenAI Тибо (Thibault Sottiaux) опубликовал в X сообщение из трех слов: «Le GPT Fat». Явный тизер скорого релиза чего-то «тяжелого». На следующий день в API OpenAI на несколько минут появились два загадочных идентификатора — rc-ada-or-vm и rc-ada-sh-vm. Разработчики, успевшие их вызвать, получили ошибку «503 Capacity Limit», после чего модели исчезли. Префикс «rc» означает Release Candidate. Суффикс «vm» указывает на архитектуру с двумя виртуальными машинами: одна планирует задачи, другая исполняет код в песочнице. Это прямо указывает на то, что новый релиз заточен под сложные агентские задачи.
Днем ранее, 2 ноября, на конференции ADIPEC 2026 Сэм Альтман подтвердил догадки. Задачу тысячелетия Навье — Стокса, которую OpenAI «решила» в сентябре, выполнила еще не выпущенная публично «следующая версия GPT». Как это работало? 10 000 ИИ-агентов под управлением новой модели трудились 88 часов без единого «босса». Полностью децентрализованная система: каждый агент самостоятельно исследовал свое направление, делился результатами и решал, что делать дальше. За это время они обменялись 2,7 млн сообщений и сгенерировали около 130 млрд токенов. Финальную формализацию и проверку доказательства в Lean провела уже GPT-6 Astra — на это ушло еще 17 часов.
Теперь пазл складывается. «Le GPT Fat» — это отсылка к той самой тяжелой модели (GPT-6.2 Astra или даже более крупной «Betelgeuse»), которая уже доказала свою мощь. А появление двойных VM в API — подготовка инфраструктуры под сети автономных агентов. Судя по архитектуре, модель проектировали под масштабные сценарии вроде штурма математических задач.
«Le GPT Fat» — не мем и не шутка. Это тизер модели, которая (пусть и силами 10 000 агентов) заставила математиков спорить о задаче тысячелетия, пока мы обсуждали мемы.
Источник: habr.com