
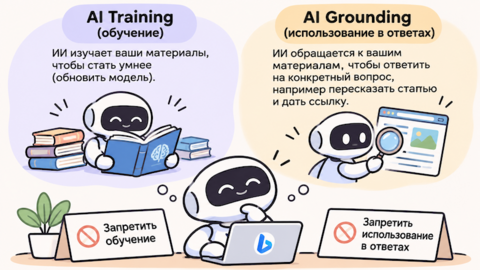
30 октября Microsoft объявила о новых правилах использования содержимого сайтов в своих ИИ-продуктах. Владельцы ресурсов смогут отдельно запрещать обучение моделей на своих материалах и использование этих материалов при генерации ответов Bing и Copilot. При этом страницы по-прежнему смогут присутствовать в обычной поисковой выдаче.
В тот же день Google сообщила, что тоже намерена поддержать общий механизм запрета на обучение ИИ. Компании ориентируются на разрабатываемый в IETF стандарт, который позволит владельцам сайтов устанавливать ограничения сразу для нескольких поставщиков ИИ, а не прописывать отдельные правила для каждого поискового робота.
Microsoft предлагает разделить два способа использования материалов:
-
AI Training (обучение) — когда тексты, изображения и другие материалы используются для обучения моделей. После обучения модель может воспроизводить усвоенные сведения, уже не обращаясь к исходному сайту.
-
AI Grounding (использование при генерации ответов) — когда ИИ обращается к материалам сайта, чтобы ответить на конкретный вопрос пользователя. Например, пересказывает статью, использует её факты и приводит ссылку на источник.
AI Training (т.е. обучение моделей) можно запретить для всего сайта, добавив в robots.txt две строки:
User-agent: __usage_ai-trainingDisallow: /Такой запрет относится именно к обучению моделей на данных сайта, а не к индексации страниц. Сайт продолжит появляться в обычных результатах Bing, если не запрещён его обход поисковым роботом.
Для AI Grounding предусмотрен отдельный запрет, в robots.txt его указать нельзя, но можно добавить в HTML-код страницы метатег:
Или передавать то же ограничение в HTTP-ответе веб-сервера:
X-Robots-Tag: Bingbot: ai-grounding:disallowэтим методом владелец сайта может запретить Bing и Copilot пересказывать свои статьи, но оставить их доступными для обычного поиска. Если нужно распространить ограничение на весь сайт, соответствующий HTTP-заголовок можно возвращать для каждой страницы.
Есть и промежуточный вариант ai-grounding:disallowextended. Он разрешает Microsoft использовать материалы в собственных продуктах, включая Copilot, но запрещает передавать их сторонним разработчикам через сервисы компании, например Web IQ и Foundry API.
Оба ограничения независимы. Можно запретить обучение, но разрешить использование статей в ответах ИИ, или наоборот. Если владелец сайта ничего не указал, Microsoft считает оба способа использования разрешёнными.
Новые правила начнут действовать с 1 февраля 2027 года по мере повторного обхода сайтов. Для владельцев ресурсов, использующих прежние ограничения NoArchive и NoCache, предусмотрен переходный период до 1 марта 2027 года. Им потребуется заменить старые настройки, а для сохранения запрета на grounding до повторной индексации может понадобиться временная настройка в Bing Webmaster Tools.
Google планирует внедрить поддержку общего запрета на обучение в течение 2027 года. Если сайт запретит обучение через новую директиву и при этом не укажет отдельных правил для Google-Extended, Google будет считать обучение запрещённым и для своего механизма. Однако отдельные настройки Google-Extended сохранят приоритет. Поддержку предложенного Microsoft механизма AI Grounding компания пока не анонсировала.
Сам проект IETF ещё не стал утверждённым стандартом. Кроме того, новые директивы представляют собой заявление о предпочтениях владельца сайта, а не техническую защиту от копирования. Их соблюдение зависит от компаний, использующих контент.
Для издателей появляется выбор: разрешать ИИ обучаться на своих материалах, позволять ему использовать их в ответах или ограничивать оба способа. Правда, Microsoft предупреждает, что запрет на grounding уменьшит присутствие сайта в ИИ-ответах и потенциальный трафик из этих сервисов. Никакой компенсации за разрешённое использование материалов новые правила не предусматривают.
Источник: habr.com