
Liquid AI, стартап разработчиков из MIT, который строит модели на гибридной архитектуре вместо чистого трансформера, выложила семейство LFM3 с открытыми весами.
В первый релиз вошли шесть моделей примерно по 2 млрд параметров. Это текстовая LFM3-1.7B, визуальная LFM3-VL-2B, голосовая LFM3-Audio-2B, омнимодальная LFM3-Omni-2B и две «decision»-модели d1-2B и d1-Omni-2B. Все они собраны на общем бэкбоне LFM3-1.7B-Base, обученном на 22 трлн токенов. Ниже разобрал модель так, как ее оценивал бы инженер перед запуском в продакшен.
Чем архитектура отличается от обычного трансформера?
Обычный трансформер в каждом слое сравнивает токен со всеми предыдущими и хранит для этого KV-кэш, который растет с длиной текста. В LFM3 так работают только 6 слоев из 24. Еще пять смотрят на окно из 256 последних токенов, а остальные 13 — короткие свертки, которые видят токен и шестерых его соседей, и их память не растет с длиной текста.
Поэтому KV-кэш занимает около 27% от обычного, а именно он тратит видеопамять на длинных контекстах. Пропорцию слоев подобрали автоматическим поиском с замерами на 14 сочетаниях устройств и бэкендов. Контекст доведен до 256K токенов отдельной стадией дообучения на 3,5 трлн токенов.
Насколько она хороша на агентных задачах?
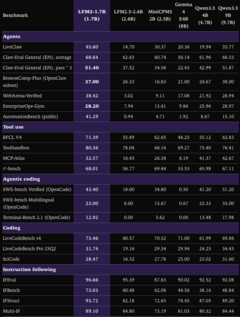
По данным самой Liquid, в таблице сравнения LFM3-1.7B набирает 71,4 на BFCL V4 тесте на вызов функций, против 62,8 у Qwen3.5 9B. На WebArena-Verified, где агент выполняет задачи в браузере, у нее 38,4 балла против 28,9 у той же Qwen3.5 9B. На IFEval у нее 96,7. Однако там, где нужны знания и рассуждения, картина обратная. На GPQA Diamond у нее 63,4 против 80,4 у Qwen, на SWE-bench Verified 43,4 против 51,2.
Вывод: модель натренирована вызывать инструменты и следовать формату, а энциклопедию в 1,7 млрд параметров не упакуешь. Все цифры пока заявлены компанией, независимых воспроизведений на момент выхода не было.
 Источник.
Визуальная LFM3-VL-2B набирает в среднем 71,4 балла по 62 бенчмаркам на понимание изображений. Это почти вровень с Gemma 4 12B (71,7) и выше, чем у Qwen 3.5 2B (64,0).
При этом ее собственный визуальный энкодер весит 164 млн параметров, а голосовая модель уступает конкурентам по WER на английском (6,2 против 5,5 у Voxtral Mini).
Можно ли запустить это у себя?
Да, и порог входа низкий. В четырехбитной квантизации текстовая модель весит около 1 ГБ. Карточка на Hugging Face описывает запуск через Transformers, vLLM и SGLang с OpenAI-совместимым API. Есть также Docker Model Runner и готовые квантизации для llama.cpp, Ollama и LM Studio. Liquid также заявляет поддержку MLX и NPU Qualcomm. Дообучать можно на одной GPU, компания выложила десяток ноутбуков под SFT, DPO и GRPO.
Сколько это стоит в продакшене?
На одной B300 при 1 024 параллельных запросах LFM3-1.7B, выдает 3,6 млрд токенов в сутки. Это примерно 42 000 токенов в секунду с одного ускорителя. Для массовых сценариев вроде классификации тикетов, извлечения полей или маршрутизации запросов между агентами такой профиль дешевле любого API среднего класса.
Главная проблема касается лицензии. Модели распространяются по LFM Open License v1.0, и, как отмечает The Neuron, компаниям с годовой выручкой выше 10 млн $ нужно отдельное коммерческое соглашение. Для большинства российских интеграторов и банков это означает переговоры с Liquid до запуска.
Что делать с этим сейчас
LFM3 занимает нишу, где раньше приходилось выбирать между облачным API и медленной 8B-моделью, запущенной прямо на рабочем ноутбуке. Если в вашем стеке есть агент, который в основном вызывает инструменты, LFM3-1.7B стоит прогнать на своих сценариях рядом с текущей моделью. На вопросы, требующие знаний, её ставить рано.
А вы уже пробовали маленькие модели в агентных задачах? Расскажите в комментариях, где они справились, а где пришлось вернуться к большой модели.
ИИ‑роутер — доступ к 400+ моделям из одной панели
Подключите OpenAI‑совместимый шлюз по единому API‑ключу. Настраивайте сквозную аналитику, отслеживайте лимиты и квотируйте ресурсы.
Запустить ИИ‑роутер →
Источник: habr.com