
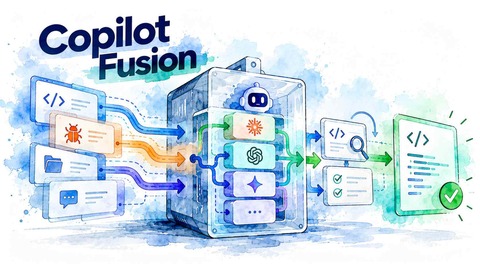
GitHub представил Copilot Fusion — систему, которая сама выбирает ИИ-модели для задач разработки и при необходимости подключает несколько моделей к одной задаче. В тестах новая система почти сравнялась с Claude Code на Claude Opus 5.5, но потребовала примерно вдвое меньше затрат на API. Разбираемся, как устроен Fusion, за счёт чего достигается экономия и что на самом деле показывают результаты тестирования.
Что такое Copilot Fusion
28 октября на конференции GitHub Universe компания представила Copilot Fusion — новый механизм автоматического выбора и координации ИИ-моделей внутри GitHub Copilot.
Идея довольно простая: разработчику больше не нужно самостоятельно решать, какую модель использовать для написания кода, отладки или работы со сложной задачей. Достаточно выбрать Copilot Fusion, а система определит, какие модели подключить и как распределить между ними работу.
В основе Fusion лежат две ранее существовавшие технологии GitHub: Project HydraFusion, отвечающий за совместную работу нескольких моделей, и Copilot Auto Model Selection — механизм их автоматического выбора.
Например, для простой задачи может хватить одной относительно недорогой модели. Если задача сложнее, система может задействовать более мощную модель или поручить проверку результата другой. При этом переключение происходит автоматически, в том числе в рамках одной задачи.
В Fusion используются модели разных разработчиков, включая Anthropic и OpenAI. Среди них — Claude Opus 5.5, Claude Sonnet 5.5, GPT-6 Astra и GPT-6 Sol. Конкретный набор моделей может меняться.
Как работает Fusion: три сценария
Copilot Fusion анализирует запрос и выбирает подходящий способ его выполнения. Всего предусмотрено три сценария.
-
Single — одна модель. Самый простой вариант: система выбирает модель, которая должна справиться с задачей, и передаёт ей запрос. Дополнительной проверки другими моделями нет.
-
Cascade — последовательное подключение моделей. Сначала задача передаётся более экономичной модели. Затем отдельная проверка определяет, достаточно ли хорош результат. Если нет, задача передаётся более мощной модели для повторного решения.
-
Critique — проверка результата другими моделями. Одна модель готовит первоначальный ответ, после чего другие модели независимо оценивают его. На основе замечаний исходная модель дорабатывает решение.
Разработчику не нужно вручную выбирать сценарий: Fusion делает это для каждого запроса. Даже в рамках одного диалога способы обработки могут различаться.
Логика понятна: нет смысла запускать несколько дорогостоящих моделей ради простой правки, но при решении сложной задачи дополнительные проверки могут оказаться полезными.
Что показало сравнение с Claude Code
Самая интересная часть анонса — результаты тестирования в Artificial Analysis Coding Agent Index v2.0. Это набор испытаний, оценивающих работу ИИ-агентов с задачами программирования.
В максимальном режиме Copilot Fusion набрал 60 баллов против 62 у Claude Code с Opus 5.5 Max. При этом средняя стоимость API-запросов на выполнение одной задачи оказалась заметно ниже.
Показатель
Copilot Fusion Max
Claude Code + Opus 5.5 Max
Общая оценка
60
62
Средняя стоимость API на задачу
$5,59
$11,42
Расход токенов
Около 7,2 млн
Примерно вдвое больше
Таким образом, при разнице всего в два балла Copilot Fusion оказался примерно на 51% дешевле по средней стоимости API на задачу. GitHub также сообщает, что Fusion выполнял задачи примерно на 40% быстрее.
Однако близкие итоговые оценки ещё не означают одинаковую эффективность во всех сценариях. Например, в Terminal-Bench 4.0 Fusion набрал 71 балл, а в FrontierCode — 51 против 56 у Claude Code с Opus 5.5. То есть преимущество зависит от конкретного типа задач.
Есть и важная оговорка по стоимости. $5,59 и $11,42 — расходы на API в рамках тестирования, а не цена использования Copilot для конечного пользователя. Эти цифры нельзя напрямую переносить на стоимость подписки или реальные расходы команды. Кроме того, показатель ускорения на 40% приводит GitHub: в опубликованном разборе Artificial Analysis нет отдельных данных, позволяющих независимо проверить именно это сравнение по времени.
Тем не менее результаты показывают, что автоматический выбор моделей и распределение задач между ними позволяют приблизиться к качеству наиболее мощных решений при меньшем расходе ресурсов.
Что доступно разработчикам
Пользователь Copilot Fusion выбирает уровень сложности обработки запроса:
-
Fusion Standard — повседневные задачи программирования с акцентом на экономию ресурсов.
-
Fusion High — более сложные задачи, для которых может потребоваться дополнительный анализ и проверка.
-
Fusion Max — наиболее требовательные задачи, где приоритет отдаётся возможностям мощных моделей.
Выбор конкретной модели и сценария её использования остаётся за системой.
Для корпоративных пользователей предусмотрены дополнительные настройки. Администраторы могут ограничивать список моделей, доступных Fusion, управлять политиками их использования и назначать Fusion вариантом по умолчанию.
Что это меняет
Интересен здесь прежде всего сам подход. GitHub предлагает выбирать не конкретную ИИ-модель, а нужный уровень качества решения. Всё остальное — выбор модели, распределение запросов и дополнительные проверки — берёт на себя система.
Похожий подход уже используют и другие разработчики инструментов для программирования. Например, Replit внедрил автоматический выбор моделей, а Ramp добавила такую возможность в своего ИИ-агента Open SWE.
Для разработчиков это потенциально означает меньше ручных переключений между моделями и более рациональный расход токенов. Правда, эффективность такого подхода ещё предстоит проверять на реальных проектах: результаты бенчмарков не гарантируют аналогичного выигрыша на конкретной кодовой базе.
Но направление выглядит вполне определённым: инструменты для ИИ-разработки постепенно переходят от работы с одной выбранной моделью к системам, которые самостоятельно решают, какие модели подключать и когда нужна дополнительная проверка.
Источники:
-
The New Stack — GitHub debuts Copilot Fusion
-
GitHub — официальный анонс Copilot Fusion
-
Artificial Analysis — результаты независимого тестирования
-
GitHub Docs — описание работы Copilot Fusion
Продолжить знакомство с возможностями ИИ-агентов в разработке можно на бесплатных вебинарах Otus, которые проведут практикующие специалисты:
-
11 ноября, 20:00. «ИИ-агент по расписанию: как заставить Claude Code работать, пока вы заняты другим». Записаться
-
23 ноября, 20:00. «Команда ИИ-агентов в разработке Python-проекта: как организовать совместную работу специализированных агентов». Записаться
Больше открытых уроков по ИИ, разработке и не только смотрите в календаре.
Источник: habr.com