
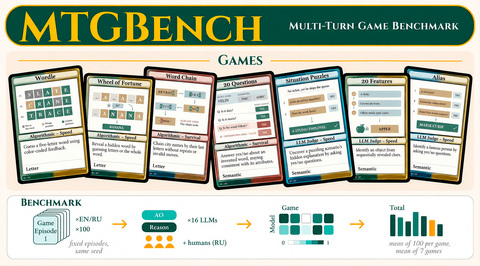
Инженеры из «Яндекса» и студенты Школы анализа данных разработали и опубликовали в открытом доступе проект MTGBench. Это набор тестов для нейросетей, который оценивает способность ИИ-систем рассуждать при выполнении сложных многоэтапных задач.
Статью об этом бенчмарке приняли на научную конференцию EMNLP 2026.
Решение MTGBench может помочь точнее подбирать рассуждающие модели под определённые задачи. Например, исследователи и разработчики могут использовать MTGBench для тестирования и сравнения различных ИИ-моделей.
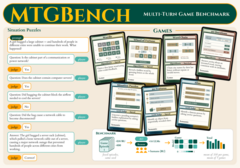
«Люди часто уточняют свои запросы к нейросети, добавляя новые вводные. Например, при планировании поездки человек может дополнительно сообщить даты и бюджет, а при обращении в службу поддержки — как он уже пытался решить задачу. А значит, нейросеть должна учитывать в рассуждениях как новую информацию, так и предыдущие шаги. Это можно проверить в играх, где каждый следующий шаг зависит от предыдущего. Именно такие задания и легли в основу нового бенчмарка. В них оценивается не только конечный ответ нейросети, но и за сколько шагов она к нему пришла», — пояснили в «Яндексе».
Решение MTGBench включает семь текстовых игр, состоящих из десятков шагов. Среди них — «Поле чудес», «Данетки», «Элиас» и Wordle. Игровые проекты помогают определить, способна ли модель логически рассуждать, использовать новые данные, продумывать следующие шаги и не противоречить своим прежним ответам. В четырёх играх правильность решений проверяют алгоритмы, а в остальных — ИИ‑судья, качество работы которого дополнительно проверили люди. Все задания даются на русском и английском языках.
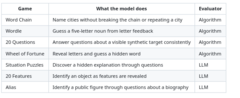
На MTGBench проверили 16 нейросетей, от компактной версии Qwen до более крупных моделей Gemini и GPT. Эксперимент показал, что эффективность режима рассуждений зависит от типа задачи. Больше всего рассуждения полезны в заданиях, где нужно работать с буквами и символами, анализировать подсказки и исключать неверные варианты. В задачах на извлечение знаний и понимание смысла улучшения оказались не так заметны и различались от модели к модели. При этом результаты разных нейросетей менялись в зависимости от задания: высокий балл в одном типе испытаний не гарантировал успеха в другом. Выяснилось также, что задания на русском языке даются моделям хуже, чем на английском.
Для сравнения исследователи предложили русскоязычные задания MTGBench людям. Участники хорошо справились с буквенными играми, однако сильнейшие модели с включённым режимом рассуждений показали более высокие средние баллы во всех семи играх.
Источник: habr.com