
Приветствую, любители нагрузки! Сразу переходим к прошлым выпускам и далее по тексту:
Прошлые выпуски
-
Новости Perfscale № 1
-
Perfscale news #2: Fix Protocol, Magic metrics и MCP
-
perfscale news #3 Websocket, Inference, NPM
-
Perfscale news #4. GRPC, Fixed Triggers, Child Process
-
Perfscale news #5. SQL, Thresholds, неработающие Linked Accounts
-
Perfscale news #6. GraphQL, поддержка Import, и метрики
-
Perfscale news #7. Fix Import, SOAP, and more HTTP metrics
-
Perfscale news #8. WS Benchmark, Jmeter open sourced & fixed linked accounts
-
Perfscale news #9. GPU, LLM, Docker images
-
Perfscale news #10. Shared variables, Pub/Sub load testing & live metrics
-
Perscale news #11. Fine‑grained token, SQID, stdout log streaming
-
Perfscale news #12. WASM‑библиотеки, SDK для авторов и «живые» логи
-
Perfscale news #13. Выжигание WASM модулей, http3 и первый postmortem
-
Perfscale news #14. Фикс fix, api reference и поддержка webrtc
-
Perfscale news #15. Локальная документация, обновленный bench, и метрик сервер
В прошлом выпуске я подсвечивал, что минуты GitHub Actions почти кончились. Теперь они кончились совсем(до следующего месяца), поэтому релиз агента 0.6.0 собран, но ещё не опубликован. Обо всем по порядку и начинаем с perfscale oss. Шучу, чтобы не быть заблокированными пришлось накинуть «пару баксов» сверху. А то без actions никак. В будущем может перенесу выполнение на собственный раннер из дома. Пока думаю над этим.
Perfscale OSS
Report SDK API
Раньше результат прогона жил в двух местах: в консоли и в perfscale serveдублировался дополнительно, для визуальной эстетики. Чтобы получить JUnit для CI или HTML для менеджеров, приходилось писать скрипт поверх JSON, что занимало дополнительно ресурсов на написание скриптов поверх JSON. Теперь в конфиге есть секция reporters:
# file: config.yamlreport: reporters: - use: std/report/json@v1 with: { path: report.json } - use: std/report/junit@v1 with: { path: junit.xml } - use: std/report/html@v1 # один HTML-файл, открывается без интернета with: { path: report.html } - use: wasm:./reporters/summary.wasmВсе репортеры читают одну модель report@v1: идентификатор прогона, агрегаты по шагам, все thresholds и сырые сэмплы, если они нужны. В JUnit каждое выражение из thresholds становится отдельным test case. CI показывает, какой порог упал, а не просто «exit 1».
std/report/html@v1 собирает отчёт в один файл в тёмной теме, без CDN и внешних шрифтов. Его можно приложить к задаче в трекере или к письму, что удобно
JSON-репортер умеет отправлять отчёт по HTTP. В заголовках работает ${VAR}. Переменные подставляются на хосте и не пишутся в логи:
# file: config.yamlreport: reporters: - use: std/report/json@v1 with: url: https://collector.example.com/reports headers: { Authorization: "Bearer ${REPORT_TOKEN}" }Свои репортеры на WASM! Если встроенных форматов оказалось мало, репортер пишется как WASM-компонент perfscale:reporter@0.1.0. В TypeScript SDK (@perfscale/library-sdk) появились defineReporter и сборка --kind reporter(лучшего решения пока не придумал. постепенно SDK переименуется в просто perfscale/sdk, но это задача для будущего меня). Как пример внешнего репортера уже есть: perfscale/allure2-reporter конвертирует report@v1 в результаты Allure. По сути это такой референс о том, как собрать репортер + тамже есть github actions официальный. Кстати, вы можете его заценить: perfscale/github-action.
Чтобы WASM не тормозил конец прогона, скомпилированный модуль кэшируется: каждый репортер компилируется один раз, а команда perfscale install прогревает кэш заранее.
Ускорение Pub/Sub
Раньше std/pubsub@v1 открывал соединение с брокером на каждой итерации. Для проверки «сколько клиентов выдержит брокер» это правильно, для проверки пропускной способности — нет. Появилось два параметра:
-
scope: vu— одно соединение на VU на весь прогон (по умолчаниюscope: exchange, соединение на итерацию. Так было по умолчанию); -
flush: none— публикация без ожидания подтверждения от брокера (по умолчаниюflush: message, ждём ack от брокера).
Добавились метрики pubsub_publish_ms, pubsub_errors и pubsub_connect_ms: последняя показывает, сколько стоит само подключение.
В ежедневный bench вошёл набор pubsub против NATS. Для сравнения взят k6 со сборкой xk6 + xk6-nats: в стоковом k6 модуля NATS нет. Последний прогон в CI (10 VU, 10 с, payload ~256 байт):
Сценарий
Msg/s
CPU на сообщение
Peak RSS
perfscale (publish, cold)
3 846
221.5 µs
22.3 MiB
k6 xk6-nats (publish, cold)
3 107
418.0 µs
53.7 MiB
perfscale (publish, warm, ждём ack)
89 923
23.8 µs
23.6 MiB
perfscale (publish, warm, flush: none)
348 435
9.6 µs
25.7 MiB
k6 xk6-nats (publish, warm)
141 469
24.1 µs
173.9 MiB
Как это читать:
-
cold — подключение на каждой итерации. perfscale быстрее и тратит вдвое меньше CPU на сообщение.
-
warm с ack медленнее k6, и это ожидаемо: xk6-nats вообще не ждёт подтверждения от брокера. Более честное сравнение с k6 — строка с
flush: none: 348K против 141K msg/s при памяти в 7 раз меньше! -
Строки, где генератор нагрузки работал в том же процессе, что и сервис, я из bench убрал, а то получалось нечестно и слишком большой RPS выдавал!
Ускорение SQL
Для std/db-* такая же история: scope: vu для db-connect опции держит соединение между итерациями. Добавились prepared: true для prepared statements и store_rows: false, чтобы считать строки, не материализуя их. Ну и выдержка из последних метрик:
Сценарий
QPS
p95 ms
Peak RSS
perfscale (warm vu)
12 739
1.18
25.6 MiB
perfscale (warm vu + prepared)
26 694
0.64
29.3 MiB
k6 (xk6-sql, warm)
16 950
1.00
56.9 MiB
jmeter (JDBC, warm pool)
16 619
—
371.5 MiB
locust (psycopg2, warm)
4 963
—
56.8 MiB
Без prepared statements perfscale пока отстаёт от k6. С ними он впереди всех, а p95 падает почти вдвое. но мы работаем над этим!
Perfscale platform
Pro-модули устанавливаются на агенте
В прошлом выпуске я писал про каталог pro-модулей (SOAP, FIX, LLM, PubSub, WebRTC, shared-redis) и о том, что они раздувают бинарник агента, ведь не каждый раз у нас запускаются все виды тестов. Теперь для каждого модуля собирается отдельный вариант агента, и все варианты перечислены в манифесте variants.json. На странице машины в админке есть раздел pro-модулей. Нужный модуль ставится через self-update агента, руками ничего копировать не надо.
Остальное
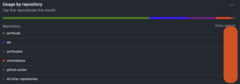
Позволю сделать отступление по поводу биллинга на github actions. Ограничение по биллингу больше всего ударило по приватным репозиториям. Для открытых репозиториев github actions все также доступен, пострадали другие. Кстати по использованию я заметил, что больше всех у нас по использованию берет perfscale oss. Отрыв у него в 4 раза от второго места. Кстати, лимиты мы уже увеличили, чтобы не быть заблокированны релизами.
А на этом на сегодня все!
Не выжирайте лимиты по биллингу и пусть ваши сервисы будут на 5 девяток!
Ссылки
-
GitHub: Perfscale/perfscale
-
Документация: в репозитории и во вкладке Docs в
perfscale serve --ui -
Платформа: perfscale.ru / perfscale.su
-
Установка: GitHub Releases или
npm i -g @perfscale/exe
-
пример репортера: https://github.com/Perfscale/allure2-reporter
-
github actions и установка обычным https://github.com/Perfscale/github-action
Источник: habr.com