
В августе мы писали о модуле alb — реализации Gateway API на Envoy в Deckhouse Platform. Теперь модуль поддерживает объект InferencePool из Gateway API Inference Extension. Через тот же шлюз, что публикует обычные приложения, можно отдавать и модели, а выбор реплики передать компоненту, который получает метрики её загрузки.
Всем привет! Я Пётр Антонов — руководитель продуктовых направлений «Сети и провайдеры для частной инфраструктуры» в команде Deckhouse. Рассказываю, почему round-robin не подходит для запросов к модели, как устроены InferencePool и Endpoint Picker и что пока придётся развёртывать самостоятельно.
Стоп, а почему вторая реплика простаивает?
Допустим, команда подняла модель на vLLM в трёх репликах и опубликовала её через обычный балансировщик. Пока запросы и контекст короткие, всё исправно работает.
Но со временем нагрузка растёт, начинают приходить запросы с длинным контекстом. Рано или поздно несколько таких запросов попадут на одну и ту же реплику. Её очередь начнёт расти, а KV-кеш (хранилище уже посчитанных частей контекста) — заполняться. В итоге следующий короткий запрос встанет в конец этой длинной очереди и будет ждать, несмотря на то что соседняя реплика свободна.
Дело здесь не в модели и не в vLLM. Запросы к LLM нагружают реплики крайне неравномерно: один запрос может обрабатываться долю секунды, а другой — несколько минут. Время выполнения зависит от длины входного контекста и генерируемого ответа.
Балансировка запросов по round-robin такой разницы не учитывает. А алгоритм least connections считает только активные соединения, без учёта длины очереди и состояния кеша на сервере модели.
Я сейчас напишу свой контроллер!
Первая мысль, которая приходит в голову, — починить всё с помощью подручных средств. Так рядом с HAProxy появляется самописный контроллер. Он читает метрики GPU и динамически меняет веса реплик. На какое-то время это действительно помогает.
Но со временем появляется новый сервер модели со своими специфичными метриками. Это ведёт к доработке контроллера, в коде которого разбирается только его автор. Поддерживать такую связку приходится самостоятельно и обходится достаточно дорого.
«Соединяем вас со свободным оператором!»
В Kubernetes для решения этой задачи есть стандартизированное решение — Gateway API Inference Extension. Это официальный проект, которым занимаются рабочие группы WG Serving и SIG Network. Объект InferencePool в нём стабилен с версии 1.0, вышедшей в сентябре 2025 года.
Это расширение добавляет в Gateway API два ключевых понятия:
-
InferencePool — пул подов сервера модели. Поды выбираются по меткам, как в Service, а в описании пула указан Endpoint Picker.
-
Endpoint Picker (EPP) — отдельный сервис, который читает метрики сервера модели: длину очереди, заполненность KV-кеша и список загруженных LoRA-адаптеров. Для каждого запроса он сообщает шлюзу, на какой под его отправить.
Конкретный под выбирает EPP: шлюз принимает запрос, обращается к EPP и отправляет запрос на выбранный под. Логика выбора реализована в EPP, поэтому её можно менять, не трогая шлюз. Стандарт поддерживают vLLM, SGLang и Triton с TensorRT-LLM, но набор метрик и настройка у них разные: для SGLang и Triton документация проекта не заявляет выбор реплики по LoRA-адаптерам.
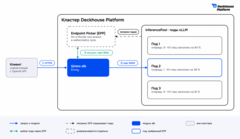 Запрос попадает на под 2: у него самая короткая очередь и KV-кеш заполнен меньше всего
Что делает модуль alb
Модуль alb поддерживает Deckhouse Platform не ниже версии 1.76. InferencePool работает во всех редакциях платформы, включая Deckhouse Platform Open: там шлюз создаётся через общий для кластера ClusterALBInstance.
Модуль ставит в кластер CRD InferencePool версии inference.networking.k8s.io/v1 из версии стандарта 1.5. Маршрут HTTPRoute может ссылаться на такой пул вместо обычного Service. Envoy обращается к EPP через фильтр ext_proc.
Маршрут к модели описывается так же, как к любому приложению: ListenerSet с TLS-сертификатом, HTTPRoute с именем хоста. Пул и маршрут выглядят так:
apiVersion: inference.networking.k8s.io/v1kind: InferencePoolmetadata: name: llm-pool namespace: llmspec: targetPorts: - number: 8000 # Порт сервера модели. selector: matchLabels: app: model-server endpointPickerRef: name: llm-epp # Service с EPP в том же неймспейсе. port: number: 9002 failureMode: FailClose---apiVersion: gateway.networking.k8s.io/v1kind: HTTPRoutemetadata: name: llm-route namespace: llmspec: parentRefs: - name: llm-listeners kind: ListenerSet group: gateway.networking.k8s.io sectionName: llm-https hostnames: - llm.example.com rules: - backendRefs: - group: inference.networking.k8s.io kind: InferencePool name: llm-poolЧто пока придётся развернуть самостоятельно
EPP в состав модуля не входит: его развёртывают рядом с сервером модели, в том же неймспейсе, что и InferencePool. В версии стандарта, которую ставит модуль, ссылка на EPP в описании пула обязательна. В инструкциях Istio, NGINX Gateway Fabric и agentgateway EPP тоже развёртывают отдельно. NGINX Gateway Fabric и agentgateway используют в своих примерах llm-d Router.
Важно: модуль alb находится на стадии Preview. Часть функциональности ещё может измениться, и при переходе на будущие версии может потребоваться ручная миграция.
Как попробовать
-
Включите модуль alb и создайте
ClusterALBInstanceилиALBInstance— по руководству администратора. -
Разверните сервер модели и EPP в одном неймспейсе.
-
Создайте
ListenerSet,InferencePoolиHTTPRouteпо примеру из раздела «Маршрутизация запросов к LLM» руководства пользователя.
Расскажите в комментариях, как вы сейчас балансируете запросы к своим моделям и каких метрик вам не хватает при выборе реплики.
Полезные ссылки
-
Новый прикладной балансировщик с поддержкой Gateway API в Deckhouse Kubernetes Platform — новость о модуле alb.
-
Gateway API Inference Extension — документация проекта: устройство EPP, совместимые серверы моделей, реализации шлюзов.
Источник: habr.com