Google обновил официальный документ о работе с ИИ-контентом в поиске и впервые заговорил о критических требованиях: ручная проверка фактов и редактура перед публикацией теперь обязательны, а не рекомендуемы. Прошлый раз этот документ правили в октябре 2025-го, так что обновление само по себе событие (Search Engine Roundtable, 2026). Параллельно активировалась вторая фаза сентябрьского спам-апдейта 2026 — 30 сентября, и аналитики уже связывают её именно с некачественным ИИ-контентом.
И Google впервые прямым текстом описал причину: нейросеть не извлекает факты — она предсказывает вероятную последовательность слов по обучающим данным. То есть галлюцинации — это не глюк, а архитектурная особенность: модель не знает ответа, она достраивает статистически правдоподобное продолжение. Отсюда и требование человека на выходе — проверить то, что модель по своей природе проверить не может.
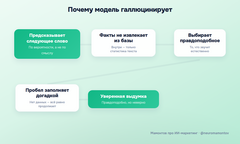 как нейросеть предсказывает слова вместо извлечения фактов
Самое забавное всегда в этих новостях с очередными рекомендациями от Google — это комментарии к ним. Подавляющее большинство про одно и то же: мол, Google своими AI Overviews специально хочет заруинить обычную выдачу, как-то обрушить её, чтобы пользователи пересели на общение с нейронкой прямо в поиске. А дальше — людей подсаживать на инструменты и в перспективе монетизировать под какой-нибудь подписной моделью или крутить рекламу. Якобы Google так гораздо выгоднее и удобнее.
Доля правды здесь есть, и связана она с прозрачностью, классическую выдачу я могу проверить: беру ключевик, задаю регион и устройство — и вижу, какая реклама крутится по мне и по конкурентам. А то, что происходит внутри диалога или в AI Overviews, ты уже никак не проверишь и не докажешь. Это закрытая коробочка, чёрный ящик. У провайдеров тут, скажем так, полный карт-бланш: они могут показывать или не показывать кому захотят и кого захотят. Возьмут покажут по вашему брендовому запросу ваших конкурентов — и вы ничего не докажете. Захотят — покажут вашу рекламу по нецелевому запросу: торгуете сыром, а всплыли в диалоге про колбасу. Неприятно, но вы об этом даже не узнаете, потому что то, что происходит в частном диалоге, остаётся частным.
 Но дело не в Google
Такую мотивацию можно притянуть к любой новости об обновлении со стороны провайдера. А вот сам исходный постулат — будто аудитория уходит в диалоговый поиск только потому, что Google его навязывает — он в корне неверен. Дело не в том, внедряет Google или нет, дело в том, что люди сами так хотят. Не добавь Google и Яндекс диалог к своим поисковикам, люди пользовались бы ими по старинке, но всё реже, и всё активнее уходили бы к чистым диалоговым моделям без собственного поиска, условно ChatGPT, Claude, DeepSeek — просто потому что для целого ряда запросов диалог удобнее.
И как следствие — вебмастера свой трафик так и так потеряли бы. Сейчас они его потеряли, и очевидно, что из-за «плохого нехорошего» Google, который эти свои ИИ-подсказки везде впихивает. А не будь их — было бы не так очевидно, аудитория Google упала бы просто потому, что ушла бы в диалоговые модели. Но и тогда можно было бы продолжать бухтеть на Google, что «плохой нехороший» Google не подсуетился вовремя и не сделал шаг навстречу аудитории, чтобы её у себя удержать. Ну вот он подсуетился и свои шаги навстречу сделал — и как следствие вебмастера как были недовольны, так и остались недовольны.
AI-Overviews здесь такое же следствие от общей более глобальной причины: аудитория больше не хочет перелопачивать уйму однотипного низкокачественного контента на таких же однотипных сайтах. Человеку нужен быстрый ответ — рецепт «пасты болоньезе», «нужно ли добавлять сахар в маринад» — и для этого не нужна выдача из 7000 сайтов с 7000 рецептов маринада на каждом, достаточно один раз выдать простой усреднённый ответ. Потребность первична, инструмент идёт за ней.
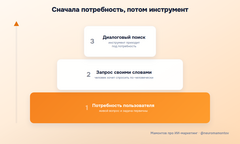 почему аудитория уходит в диалоговый поискЧто Google рекомендует
Суть рекомендации к спам-апдейту: не злоупотреблять так называемым масштабируемым контентом — то есть нейроконтентом, который создаётся слишком легко, с нулевой или очень малой добавочной ценностью. По сути это призыв делать контент уникальнее, как и всегда у Google. Разница в метрике. Раньше уникальность мерилась механически — числом повторяемых слов и предложений, которые встречались буквально символ в символ. Теперь она смысловая.
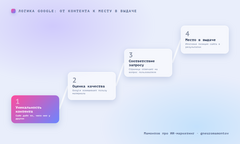 Схема логики Google: от уникальности контента к месту сайта в выдаче
Логика тут очень конкретная: сайт, который занимается генерацией низкокачественного быстро масштабируемого контента, с большой долей вероятности не создаёт пользы ни в самом контенте, ни для посетителя. Информационный он или коммерческий — если смыслов не прибавляется, добавочной ценности не создаётся, значит сайту попросту нечего сказать. Ни для коммерческого запроса, ни для информационного. А если ему нечего добавить к тому, что уже есть в интернете — значит, скорее всего, это не очень качественный сайт, и высоко в выдаче мы его не покажем, аудиторию ему не отдадим.
Логика обратная тоже предельно понятная. У любой коммерческой организации, которая годами ведёт реальную хозяйственную деятельность, всегда есть что рассказать: опыт, наблюдения, наработки. Что ж тут далеко за примером ходить: моему агентству чуть меньше 10 лет, и у меня в черновиках сейчас больше 1400 заметок, по каждой из которых я мог бы написать статью или пост. И это только то, что накопилось буквально за последние год-полтора-два, как я эти заметки начал вести. Поработать с этим основательнее, на дистанции в несколько лет — объём можно увеличить раза в три-четыре. А это только одна тематика и только один сайт одного агентства, хоть и входящего в топ-10 по России. Представьте, что таких тематик десятки, а сайтов, которые занимаются разным диджиталом, соответственно сотни, и каждый может генерировать по тысяче публикаций в месяц. Пищи для материалов очень много, и берётся она именно из человеческого опыта — того, чего у нейронки не может быть по определению. Вот это и есть новое определение качества.
А вебмастера продолжают, как бы бухтеть на одни и те же темы, потому что в их представлении всё должно было оставаться таким же, как прежде, и не меняться — чтобы они и дальше продолжали пилить свой низкокачественный контент. И по сути даже неважно, пилили ли они его с помощью инструментов быстрого масштабирования типа нейросетей или, как это было в эпоху до нейросетей, просто руками каких-то грошовых копирайтеров, которые рерайтили друг у друга одни и те же статьи по сто тысяч раз. А нам, потребителям, остаётся только сказать: слава богу, что эта эпоха наконец-то заканчивается.
Как Google определяет ИИ-тексты
Надо отдать должное: алгоритмы оценки того, насколько ваш материал уникальный, авторский, насколько он содержит ценность для целевой аудитории, конечно же пока не идеальны. Но при этом они очень здорово выросли в уровне точности, с которой определяют тот самый низкокачественный контент, причём за относительно небольшой период — какие-то 6-8 месяцев. Особенно это заметно на контрасте с публичными ИИ-детекторами, которые работают откровенно слабо.
Буквально полгода назад я ради прикола прогонял через эти публичные детекторы разный контент, в том числе свои публикации, написанные полностью вручную ещё в 2018-2019 годах, задолго до эпохи повального увлечения нейросетями. И мне эти детекторы на голубом глазу показывали от 78 до 99 процентов нейротекста. При том что элементарнейшая проверка могла бы показать, что текст опубликован в 2018-м, когда моделей в таком открытом свободном использовании ещё не было. А я тут же, ради прикола, генерировал пару абзацев в какой-нибудь самой дешёвой модели типа GPT-3 на вольную тему и относил туда же, в эти детекторы, — и получал усреднённо от 20 до 5 процентов нейротекста.
То есть точность настолько низкая, что генератор на подкидывании монетки угадывал бы чаще.
Сейчас история работает совсем по-другому. Детекторы я, правда, давно не тестировал, но вижу это не по ним, а по эффекту качественного контента на позиции сайта. Был проект, где несколько лет подрядчик генерировал нейроконтент, особо не стесняясь и не заморачиваясь на дело качеством. Стоило начать убирать этот контент и отдавать предпочтение своим уникальным материалам — опираясь на реальный кейс, на реальную фактуру именно этой компании, авторским статьям, написанным с опорой на речевой и экспертный профиль конкретного специалиста — позиции сразу на это откликнулись. Про сам подход с речевым профилем я подробно веду дневник разработки своего контент-движка, если хочется копнуть в механику.
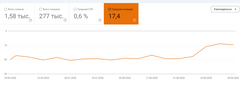
Правда, это очень объёмный пул работ, особенно когда на сайте, повторюсь, несколько лет было нагенерировано несколько тысяч таких неуникальных текстов. Фактически с появлением спам-апдейтов от Google, где он стал наказывать за такой низкокачественный масштабируемый контент, для сайта это сработало как, ну, фильтр пессимизации. Позиции сайта просто методично падали полтора года, особенно заметно с начала этого года, когда спам-апдейты стали находить регулярно.
Что делать практикам
Как потребители мы, естественно, будем всё больше уходить в диалог, всё чаще взаимодействовать с поиском в формате переписки — это удобно, и это нормально. А как собственники бизнеса, маркетологи, вебмастера — те, кто в профессиональном смысле отвечает за продвижение, — мы в положении попроще: наша задача сделать это продвижение эффективным.
И рекомендация тут ровно одна: добавляйте ценность к своим публикациям. Делитесь своими наработками, опытом, надиктовывайте, да, как это делаю я, свои кейсы — потому что весь ваш многолетний опыт не заменит никакая нейронка, а от вас это потребует просто каких-то минут, чтобы высказать мнение по тому или иному вопросу. Своё мнение по этой новости я, например, высказал на 15 минутах голосовых надиктовок. Проверка фактов человеком, которую Google настойчиво рекомендует внедрять, — это не бюрократия, а ровно та добавочная ценность, которую модель не создаёт по своей природе.
Источник: habr.com