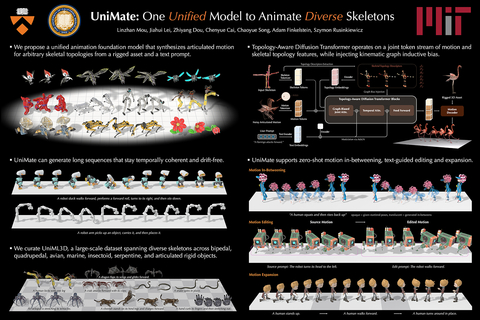
Исследователи из Принстона, Калифорнийского университета в Беркли, Массачусетского технологического института и Наньянского технологического университета представили UniMate — модель машинного обучения, которая анимирует 3D‑объекты по текстовому описанию. Одна нейросеть одновременно работает с 3D‑моделями людей, животных и с подвижными деталями предметов.
UniMate получает на вход модель персонажа с готовым цифровым скелетом и по описанию генерирует анимацию с учётом строения этого скелета. В основе нейросети лежит генеративный трансформер, который учитывает связи между суставами, исходную позу и расстояние вдоль цепочек костей. Благодаря этому модель получается универсальной, и её не надо обучать анимации каждого типа персонажа с нуля.
Система умеет и редактировать готовую анимацию. Например, можно сохранить поворот головы, но заставить тело двигаться в другую сторону. Кроме того, UniMate достраивает движения между заданными позами и соединяет действия в последовательности. Все эти задачи выполнять одна модель.
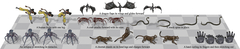
Обучал UniMate на датасете из более чем 13 тыс. анимационных последовательностей с текстовыми описаниями на основе Truebones, Mixamo и Objaverse‑XL. Исходные данные перед обучением очистили и привели скелеты к общему формату.
Согласно тестам, генерация 60 кадров занимает около 1,2 секунды на одной Nvidia H100. В слепых оценках с 32 участниками UniMate получила среднюю оценку 4,62 из 5 за соответствие тексту, правдоподобие и выразительность движений, а также сохранение формы персонажа. AnimateAnyMesh набрала 2,81, V2M4 — 2,41.
Код и веса модели опубликованы по лицензии MIT. У публичной версии есть ограничение: она создаёт фрагменты д, а для более длительной анимации их надо соединять между собой.
Источник: habr.com