
У Supersonic Labs вышла Julia 1 — небольшая модель для классификации текстов и выбора из заданных вариантов. В ней 144 млн параметров, веса занимают около 550 МБ, а для запуска достаточно CPU.
По идее это напоминает Jev от TypeSafe: модель получает данные и возвращает решение, которое можно сразу использовать в коде. Например, определяет категорию обращения в поддержку, выбирает приоритет задачи или отвечает «да» либо «нет» на вопрос по тексту.
У Julia 1 простой интерфейс: контекст, вопрос и от 2 до 20 вариантов ответа. На выходе — выбранный вариант и оценки для всех предложенных. Список вариантов можно менять при каждом запросе.
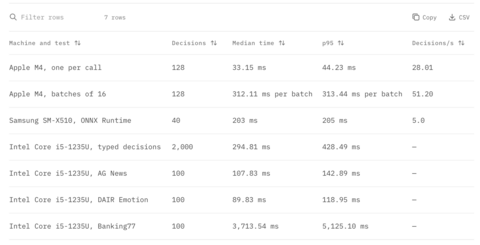
Веса модели опубликованы под Apache 2.0, поэтому обработку можно выполнять локально, без отправки данных во внешний API. В основе лежит многоязычный энкодер mmBERT-small. Авторы проверили запуск на обычных компьютерах и даже Android-планшете. На Mac с M4 короткий запрос с четырьмя вариантами занимал около 33 мс.
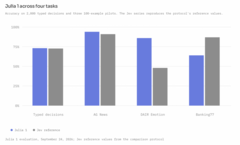
Разработчики также сопоставили результаты Julia 1 с опубликованными показателями Jev. На небольших тестах классификации новостей и эмоций Julia оказалась впереди, а на банковских обращениях заметно уступила: 64% против 87%.
По словам команды, облачные GPU для обучения и экспериментов обошлись примерно в $104. Правда, это расходы на работу поверх готового mmBERT-small, а не на обучение языковой модели с нуля.
Веса, инструкции по запуску и результаты тестов — на Hugging Face.
Если новость понравилась, приглашаю в канал AI for Devs. Каждый день публикую похожие материалы: новые модели, агенты, практические кейсы и новости из мира AI.
Источник: habr.com