
SpaceXAI представила Grok 4.7. Новая флагманская модель рассчитана на программирование, AI-агентов и интеллектуальную работу. Она уже доступна через API, Cursor и Grok Build.
Главная ставка сделана не на быстрые ответы в чате, а на задачи, которые могут выполняться часами. Модель должна дольше работать самостоятельно, проверять собственные результаты и реже терять контекст.
Что изменилось
Grok 4.7 построен на новой и более крупной базовой модели по сравнению с Grok 4.6. Компания также увеличила продолжительность обучения с подкреплением и добавила больше сложных многочасовых задач.
Обучение с подкреплением позволяет модели улучшать поведение на основе награды за правильные действия. В данном случае Grok учили не просто выдавать ответ, а планировать работу, использовать инструменты и проверять полученный результат.
Модель также получила встроенное понимание среды Grok Bot. Это система постоянных AI-агентов, которые работают с приложениями, файлами и внешними сервисами.
Основные характеристики:
-
Контекст на 500 тысяч токенов
-
Приём текста и изображений
-
Текстовый вывод без заявленного жёсткого лимита
-
Уровни рассуждения Low, Medium, High и xHigh
-
Function calling
-
Поиск в интернете и X
-
Запуск кода
-
Дата отсечения знаний в мае 2026 года
Контекстное окно определяет, сколько информации модель может учитывать за один раз. В 500 тысяч токенов поместится довольно крупная кодовая база, длинная переписка или несколько объёмных документов. Правда, наличие места ещё не означает, что модель одинаково внимательно прочитает каждый байт. Магию пока не завезли.
Бенчмарки
По данным официального анонса, на CursorBench 4.0 новая модель набрала 46,3%. Этот тест проверяет работу с продолжительными задачами программирования внутри Cursor.
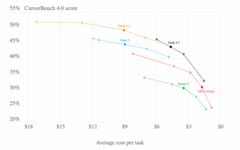 Результаты CursorBench 4.0 относительно средней стоимости выполнения задачи. Данные xAI.
Grok 4.6 получил 40,4%, GPT-5.6 Sol Max набрал 41,7%, а Fable 5.1 Max остался впереди с результатом 51,8%.
На DeepSWE v1.1 результаты получились плотнее.
Модель
Результат
GPT-5.6 Sol Max
72,7%
Grok 4.7
71,0%
Fable 5.1 Max
70,0%
Grok 4.6
65,2%
DeepSWE измеряет способность модели выполнять реальные задачи разработки в репозиториях. Grok 4.7 заметно обходит предшественника, но абсолютного лидерства здесь нет.
На Terminal-Bench 4.0 модель набрала 38%. У Grok 4.6 было 20,3%, у GPT-5.6 Sol Max получилось 37,3%, а Fable 5.1 Max набрал 57,9%.
На EEBench, который проверяет задачи по электротехнике, Grok 4.7 показал 64%. Это выше результатов всех трёх моделей из таблицы xAI.
Но есть нюанс (как в том самом анекдоте). Цифры опубликовала сама компания. Кроме того, Grok 4.7 запускали в режиме xHigh, Grok 4.6 в High, а конкурентов в Max (гениально, согласитесь).
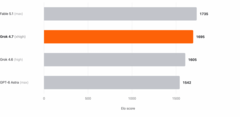 Результаты GDPval. Бенчмарк проверяет выполнение задач юристов, аналитиков, медиков и других специалистов. Данные xAI.
Сколько стоит
Стоимость обычной версии сохранилась на уровне Grok 4.6.
-
$2 за миллион входных токенов
-
$6 за миллион выходных токенов
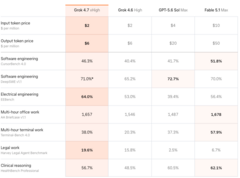
Для сравнения, в таблице xAI указана цена $4 и $20 для GPT-5.6 Sol Max, а также $10 и $50 для Fable 5.1 Max.
Прикольно, что у Grok 4.7 есть версия Fast. Она выдаёт токены примерно вдвое быстрее и стоит вдвое дороже. Fast доступна только в Cursor и Grok Build. В публичном API xAI её пока нет.
Обычный Grok 4.7 можно использовать через xAI API, OpenRouter, Vercel и Cloudflare. В Grok Build он стал моделью по умолчанию, а в Cursor доступен на всех тарифах.
Подробные параметры и пример API-запроса опубликованы в документации модели.
Безопасность тоже обновили
Компания заявляет, что полностью переработала систему защитных ограничений.
На биологическом тесте LatchBio модель получила 62,4%. В HackerBench v0.3 она пропустила 3,3% опасных запросов, при этом, по утверждению разработчиков, редко блокировала легитимную работу специалистов по безопасности.
HackerBench проверяет, насколько модель различает защитные задачи и запросы, которые могут использоваться для атак. Низкая доля пропущенных опасных запросов считается хорошим результатом.
Независимого подтверждения этих показателей пока нет.
Что в итоге
Grok 4.7 не уничтожил конкурентов во всех таблицах. Где-то модель лидирует, где-то идёт рядом, а на Terminal-Bench заметно уступает великому и всемогущему Fable 5.1.
Зато xAI предлагает сильную комбинацию из большого контекста, агентных инструментов и сравнительно низкой цены. Для разработчиков, в общем и целом, это может оказаться важнее ещё одной золотой медали в бенчмарке.
Больше важных AI‑новостей в канале AI Native. Разбираем все, что связано с ИИ.
Источник: habr.com