
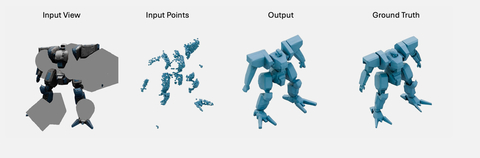
Nvidia представила Axolotl3D — генеративную модель для восстановления и редактирования 3D‑объектов по неполным данным. Она учитывает несколько фотографий, положение камеры, маски видимости и частичное облако точек, а после восстанавливает недостающую геометрию.
Современные модели image‑to-3D рассчитаны в первую очередь на генерацию по изображению, на котором предмет хорошо виден целиком. При этом на реальных фотографиях часть объектов может быть скрыта, а некоторые фрагменты и вовсе не попадают в кадр. Исследователи Nvidia предлагают решать эту проблему с помощью объединения в одну задачу реконструкции, восстановления скрытых частей и редактирования геометрии.
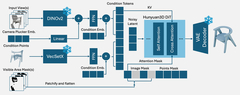
Модель Axolotl3D построена на базе Hunyuan3D 2.1. Нейросеть принимает на вход до шести изображений предмета, после чего DINOv2 извлекает из них визуальные признаки и данные о положении камер, а энкодер VecSetX обрабатывает облако точек. Система объединяет всю полученную информацию и передаёт в диффузионный трансформер, который формирует готовую форму. На финальном этапе ShapeVAE превращает её в 3D‑меш.
Справиться с галлюцинациями модели помогает облако точек. Уже известная геометрия выступает в качестве якоря, а нейросеть генерирует части объекта, информации о которых мало.
Axolotl3D обучали на 407 тыс. моделей из датасета TRELLIS-500K. Перед обучением трёхмерные модели намеренно «портили»: скрывали части объектов, удаляли фрагменты облаков точек и убирали часть ракурсов. Нейросеть обучали на восьми ускорителях Nvidia A100.
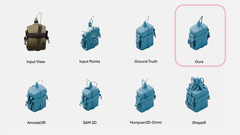
У модели пока есть ограничения: её обучали на изображениях с фиксированными параметрами и расстоянием до камеры, поэтому объект должен полностью помещаться в кадр. Код и веса Axolotl3D пока не опубликовали.
Источник: habr.com