
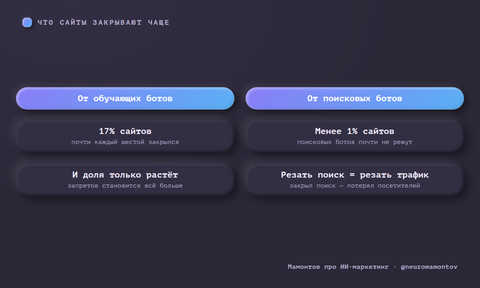
Буду первым, кто не просто перепостит новость про обновление Cloudflare, а ещё и по существу прокомментирует, почему тема разделения ботов на поисковых и обучающих так важна для владельцев сайтов. Что показательно, тема ещё и совсем не новая: эти разговоры я слышал ещё года полтора назад — тогда все обсуждали формат llms.txt, который, к слову, так толком и не взлетел. Но ключевая идея была очевидна уже тогда: желающих закрыть свой сайт от обучающих ботов в разы больше чем желающих закрыть сайт от поисковых ботов — 17% против менее чем 1% (оценка самого Cloudflare, 2025).
В чём разница
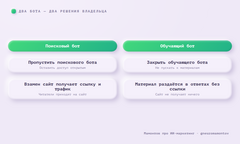
Одно дело — тебя проиндексировал поисковый краулер и потом процитировал: в классической выдаче или в AI-обзоре, но со ссылкой на источник. Это дополнительный трафик, а трафик автору нужен как воздух: вся монетизация в конечном счёте живёт на самом сайте — реклама, подписки, свои продукты, нативка, реферальные ссылки. Способов много, но каждому нужен свой трафик на своей площадке. Поэтому индексацию блокирует меньше 1% сайтов — резать поисковых ботов равно резать себе выручку.
Совсем другое дело — когда модель поглотила твой материал и выдаёт всю фактуру и выводы прямо в окне ответа. Может даже упомянуть тебя как автора, но без ссылки и без перехода — просто “есть такое мнение”. И всё, над чем ты пыжился-мурыжился — писал, агрегировал многолетний опыт, чтобы поделиться с аудиторией и потом это монетизировать, — модель раздаёт бесплатно. Отсюда и 17%: это те, кто очень захотел и нашёл способ, хотя способы неочевидные и на поверхности не лежат. Дальше цифра будет только расти.
Кто на самом деле блокировал разграничение
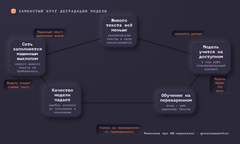
Ключевой момент: тормозили не вебмастера, а провайдеры ИИ-моделей. Им как раз нужно обучать модели на свежем человеческом контенте — без него модели деградируют, причём быстро. Это уже наблюдаемый эффект: интернет заваливает сгенерированным контентом, и модели всё чаще учатся на «трижды пересказанных» идеях.
Отсюда парадокс: одной рукой ИИ-компании хотят всё больше оригинального человеческого текста (иначе никак), другой рукой те же операторы обязаны предложить механизм, который устроит издателей: пустить поискового краулера и не пустить обучающего. Формат llms.txt должен был это закрыть, но не закрыл — часть провайдеров просто отказалась его поддерживать и соблюдать директивы.
Что технически изменил Cloudflare
За Cloudflare стоит больше 20% сайтов по всему миру. Заявлено, что компания договорилась с большинством крупных операторов через категорию Accountable: платформы обязуются соблюдать opt-out, обеспечивать прозрачность на уровне URL и гарантировать, что отказ от обучения не бьёт по позициям в поиске. В панели теперь три типа поведения роботов (поиск, обучение, агенты) и четыре режима блокировки, включая отдельный для страниц с рекламой. Google и Apple под критерии уже подходят, Microsoft обещает докрутить поддержку в начале 2027 года. Технически всё это ложится в robots.txt с директивой на запрет обучения при открытом доступе для поисковых роботов (разбор Cloudflare, 2025).
Cloudflare просто приняли решение удовлетворить потребность, которая на рынке с каждым днём всё заметнее, и будет всё сильнее с каждым периодом, так как нейровыдача меняет не только методы продвижения, но и сами паттерны поискового поведения интернет-пользователей — я разбирал это отдельно в материале про GEO как новую эпоху продвижения в нейросетях.
Почему я не жду, что заработает как надо
Разделить ботов механически на стороне сайта нельзя в принципе: один и тот же бот заходит сразу с двумя задачами — и формирует поиск, и обучает модель. Ни по user-agent, ни по IP их не растащить. Значит, вся конструкция держится на честном слове операторов и обещании соблюдать директивы. Верифицируемого способа проверить исполнение у вебмастера по-прежнему нет.
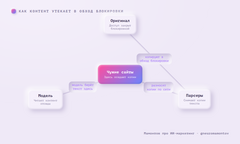
Но главная дыра даже не в этом. Контент утягивают не только модели, которые на нём учатся. Есть масса парсеров, которые просто забирают текст и бесплатно перепубликуют его у себя. Я как автор сталкиваюсь с этим постоянно: каждая публикация всплывает на трёх-пяти-десяти чужих сайтах. Будут ли те сайты закрываться от обучающих краулеров? Скорее всего нет. То есть модель не возьмёт мой материал с моего домена — но возьмёт его с чужого)
Куда это движется
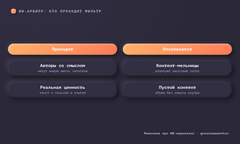
Вектор при этом верный. Недавно проходила новость, что Google начал деньгами мотивировать издателей за использование их контента в ответах нейросетей — пока в тестовом режиме, но это по сути тот же разговор — рынок пытается нащупать баланс: без живого человеческого текста модели деградируют, а человеку должно быть выгодно этот текст отдавать.
Моделям нужен тот, кому есть что сказать; на пересказе пересказов они «задыхаются». В сухом остатке ценность должна остаться у авторов, способных передавать смысл, опыт, фактуру.
Источник: habr.com