
Алиса AI теперь анализирует запрос и выбирает модель, которая лучше справится с задачей пользователя. Для повседневных задач ассистент выбирает модели, которые быстро подготовят ответ. А если нужно учесть много условий, изучить несколько документов, выполнить расчёты или составить пошаговый план — подключает режим «Эксперт». Его можно включить и вручную, но по умолчанию Алиса AI сама определяет, когда он нужен. Быстрые ответы остаются быстрыми, а задачи со множеством условий получают больше ресурсов.
Сейчас около 80% запросов обрабатывает модель Alice AI LLM. Мы каждый день тестируем разные модели для режима «Эксперт» и планируем регулярно обновлять их набор. В нём могут использоваться как решения из семейства Alice AI, так и общедоступные модели с открытыми весами, работающие на серверах Яндекса.
Расскажем, почему Алиса AI использует разные модели и как выбирает подходящую под задачу. А ещё объясним, почему модель — ещё не весь продукт, что такое харнесс и как мы с помощью бенчмарков проверяем его влияние на качество ответов.
Как Алиса AI выбирает модель
Кажется, что проще выбрать самую умную модель и отправлять ей все запросы. Реальность сложнее: в среднем сильные модели демонстрируют схожее качество ответов, но при этом для каждой можно найти специализированный запрос, с которым она справляется заметно лучше других. Кроме того, отвечать более сильной моделью на простые запросы будет занимать больше времени, не принося выигрыша по качеству ответа. Поэтому пользователь получает лучший результат, когда система подбирает модель для каждого запроса, а не использует одну и ту же для всех.
В Алисе AI этот выбор делает специальный классификатор. Он анализирует запрос, оценивает, сколько ресурсов потребуется для подготовки ответа, и определяет, какая модель лучше справится с задачей.
Например, Алиса AI может автоматически включить режим «Эксперт», если пользователь просит спланировать поездку в Стамбул на четыре дня для двоих в пределах 120 тысяч рублей или подобрать робот-пылесос дешевле 40 тысяч рублей, который справится и с коврами, и с шерстью кота.
Почему модель — ещё не весь продукт
Сама по себе модель ещё не гарантирует хороший ответ. Его качество зависит не только от того, насколько хорошо модель рассуждает, но и от доступных ей данных, инструкций и инструментов.
Харнесс — слой между моделью и продуктом. Среди его компонентов — системный промпт и инструменты. Системный промпт задаёт правила работы модели, а инструменты позволяют получать и обрабатывать сведения, необходимые для ответа. Например, с помощью поиска модель получает актуальную информацию, а в Python-песочнице может писать и запускать скрипты для решения задачи.
Ещё одна часть харнесса — агентный цикл, который позволяет модели решать задачу по шагам. Модель вызывает нужный инструмент. Результат его работы добавляется к уже собранным данным, после чего модель решает, нужен ли следующий шаг или уже можно ответить пользователю. Между шагами сохраняются данные, необходимые для продолжения работы, поэтому не приходится начинать каждый новый шаг с нуля.
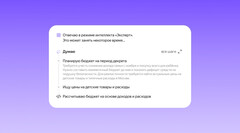
Запрос, инструкции и результаты работы инструментов образуют контекст — информацию, которую харнесс передаёт модели. По мере выполнения задачи контекст растёт, но модель может обработать только ограниченный объём информации. За объёмом контекста следит отдельная часть харнесса — контекст-менеджер. При приближении к лимиту он передаёт модели инструкцию перейти к итоговому ответу, чтобы оставшегося места в контексте хватило для его подготовки.
Для работы с файлами в харнессе предусмотрен отдельный набор инструментов. Сначала документ переводится в понятный модели вид: текст извлекают парсеры, а содержимое изображений и страниц PDF при необходимости распознаёт наша VLM-модель. Чтобы не тратить контекст на чтение объёмного документа, модели доступен RAG-поиск по файлу. Более того, если готового инструмента для работы с файлом нет, модель может сама написать недостающий скрипт на Python. Работа с файлами часто требует нескольких последовательных действий, поэтому для запросов с текстовыми файлами Алиса AI по умолчанию включает режим «Эксперт».
За подготовку результата для интерфейса отвечают ещё две части харнесса. Суммаризатор размышлений и вызываемых инструментов кратко описывает выполненные действия, а рендерер готовит это описание и итоговый ответ для показа пользователю.
Как мы проверяем, что харнесс помогает модели
Во многих популярных бенчмарках изолированной модели дают задания, специально составленные для теста и не похожие на реальные запросы пользователей, а также несколько готовых вариантов ответа. Такой формат упрощает задачу: модель может выбрать правильный вариант, исключив явно неверные, даже если не смогла бы самостоятельно найти и сформулировать ответ.
Если же модель пишет ответ сама, возникает другая проблема: у открытого вопроса обычно нет единственной правильной формулировки. Без заранее заданных критериев как человек, так и модель-судья оценивают ответ исходя из общего впечатления и собственных знаний.
Поэтому мы собрали собственный бенчмарк из сложных для ИИ задач, которые при этом похожи на реальные запросы пользователей. Между собой мы называем его «Сложным бенчмарком». В текущей версии v0 — около 50 задач, собранных с помощью коллег. Мы уже работаем над тем, чтобы увеличить их число как минимум в десять раз.
Один из вопросов в бенчмарке звучит так: «Перечисли игумений, вышедших из Толгского монастыря». В нём всего шесть слов, но, по нашим замерам, ни одна из протестированных моделей пока не смогла дать полный ответ. В интервью настоятельницы Свято-Введенского Толгского женского монастыря игумении Варвары звучат в разное время разные числа — от 16 до 20, но нигде в интернете нет ни готового списка, ни единого справочника, на основе которого можно было бы составить полный ответ. Чтобы справиться с задачей, нужно по отдельности находить настоятельниц российских монастырей, изучать их биографии и проверять, кто из них раньше был послушницей Толгского монастыря. Мы сейчас знаем 17 имён, но ни одна из моделей (точнее, сервисов, так как без поиска эта задача не решаема) не может назвать все 17 без ошибок.
Для каждой задачи мы вручную задаём положительные и отрицательные критерии оценки ответа. Например, в задаче про игумений за каждую подтверждённую фамилию начисляются баллы, а за заведомо неверную — снимаются. Затем модель-судья проверяет ответ по каждому критерию и ставит оценку от 0 до 100.
Чтобы проверить качество харнесса, мы прогоняем на бенчмарке доступные нам внутренние и внешние модели. Чаще всего мы тестируем одну и ту же модель как минимум дважды: с нашим харнессом, в конфигурации её авторов и, по возможности, ещё в некоторых вариантах «упряжи». Всего мы провели более 50 замеров, охватив самые разные модели и конфигурации. Лучший результат составил 71 балл из 100 возможных (это GPT-6 Astra Pro), а худший — 23.
Как харнесс влияет на качество ответа, покажем на примере модели с открытыми весами GLM 5.2 high. С нашим харнессом она получила 48 баллов, а в конфигурации авторов модели — 43.
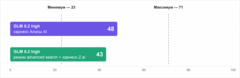
Конечно, мы сравниваем наш харнесс с другими не только на собственном «Сложном бенчмарке», но и на десятках других бенчмарков. Везде видим одну и ту же картину: модель с нашим харнессом показывает как минимум такой же результат, как с другими харнессами, а в некоторых случаях — более высокий.
Мы считаем, что существенный вклад в этот результат вносит наш поисковый инструмент: он находит и готовит исходные материалы для модели. При этом в самом инструменте применяются модели, обученные в Яндексе. Это показывает, что современные, сложные сервисы уже представляют собой ансамбли моделей, каждая из которых решает свою часть общей задачи. Итоговое качество продукта зависит от того, насколько удачно сочетаются все эти модели и насколько эффективно харнесс организует работу с ними.
Попробуйте Алису AI на своих задачах — например, попросите сравнить документы, спланировать поездку или разобраться в вопросе с несколькими условиями. Делитесь в комментариях, с чем ассистент справился, а где ответ оказался неполным или неточным. Такие примеры помогут нам понять, что ещё нужно улучшить.
Источник: habr.com