
Это модель Mixture-of-Experts (MoE) с тернарным квантованием весов, которая работает очень быстро: 218 токенов в секунду на Mac Mini M4.
Главные особенности Maple-Preview:
-
Архитектура: 24 слоя, 256 экспертов, из которых для каждого токена используются только 8.
-
Параметры: Всего 20 миллиардов, из которых активны 1 миллиард (20B-A1B).
-
Веса: Тернарные, что означает примерно 2 бита на параметр.
-
Контекст: Обрабатывает до 131 072 токенов.
-
Размер: Всего 5.31 ГБ.
-
Внимание: Использует скользящее окно (SWA-512) и глобальное внимание в соотношении 3:1, а также нормализацию Q/K RMS и FFN MoE с SiLU-гейтом (как в DeepSeek v4).
Производительность и железо:
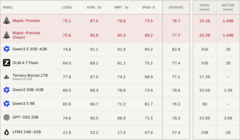
Самое впечатляющее — это скорость генерации. Авторы заявляют, что на обычном Mac mini с чипом M4 модель выдает до 218 токенов в секунду при работе на CPU. Это намного быстрее, чем у многих других моделей такого же размера. Благодаря тому, что модель занимает всего около 5 ГБ, она помещается в оперативную память большинства современных компьютеров. Это открывает возможности для создания локальных помощников, которые могут работать с длинным контекстом и помогать с кодом, не отправляя ваши данные в облако.
Ссылки: Github HF
Источник: habr.com